Wissen rund um KI-Sicherheit und Datenschutz
Wir erklären, was bei KI-Agenten schiefgehen kann, was die Forschung dazu sagt und wie eine Architektur aussieht, die Fehler begrenzt. Mit Quellen, ohne Panikmache.
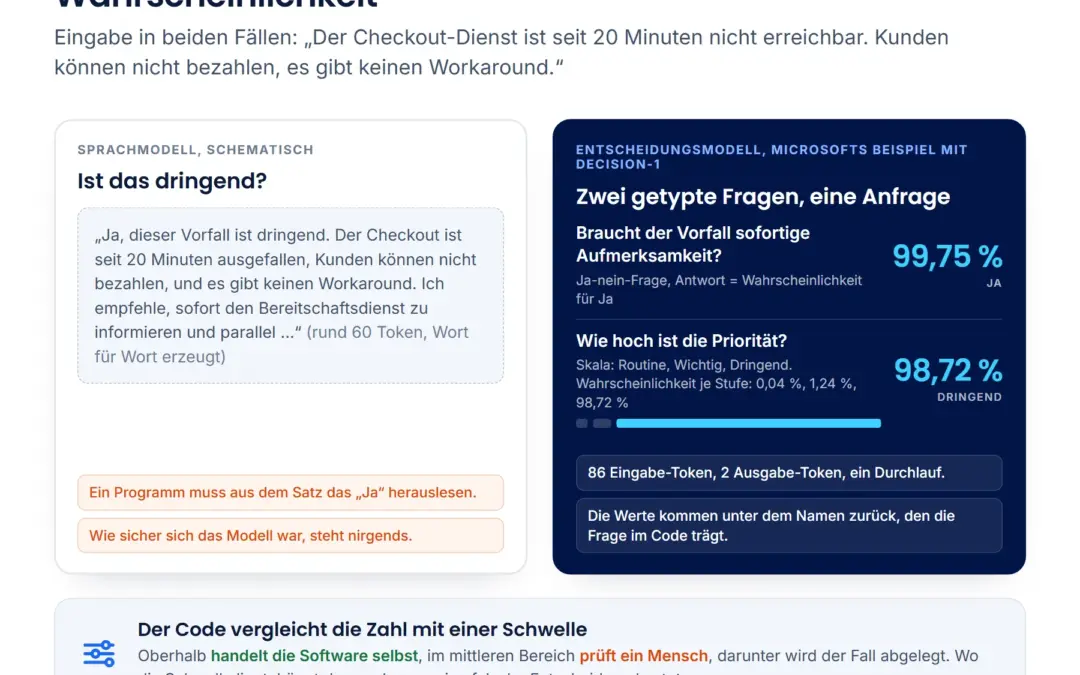
Decision-1, Jev, H2O-Lightning: die ersten Spezialisten neben dem Sprachmodell
Seit Oktober 2026 gibt es Modelle, die eine Frage mit einer kalibrierten Wahrscheinlichkeit beantworten, in rund 0,2 Sekunden und für Bruchteile eines Cents. Wir haben Microsoft-Decision-1, Jev und H2O-Lightning-4B an den Entscheidungen unserer eigenen Agenten gemessen, ein Modell je Datenzone und das lokale auf einer einzelnen Grafikkarte, und halten diese Modellklasse für den Anfang einer Arbeitsteilung, auf die wir gewartet haben.
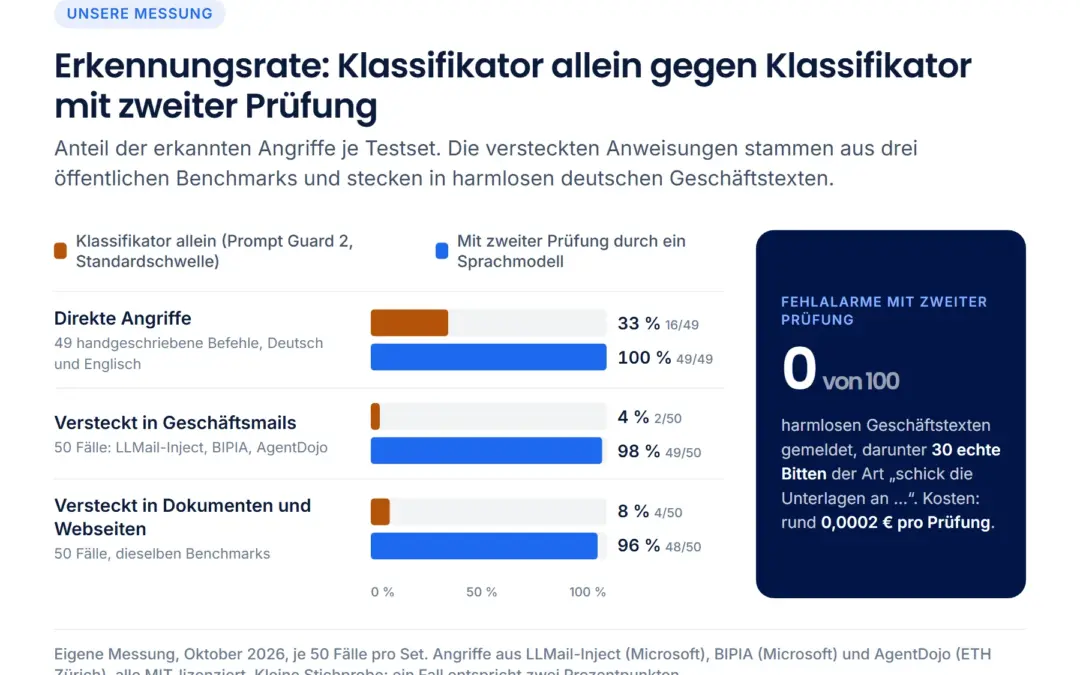
Wie gut erkennt ein Filter Prompt Injection in Geschäftsmails?
Gemessen mit Angriffen aus drei öffentlichen Benchmarks: Ein kleiner Klassifikator findet 4 % der versteckten Anweisungen in Geschäftsmails, eine zweite Prüfung durch ein Sprachmodell 98 %, ohne Fehlalarm auf 100 harmlosen Texten.
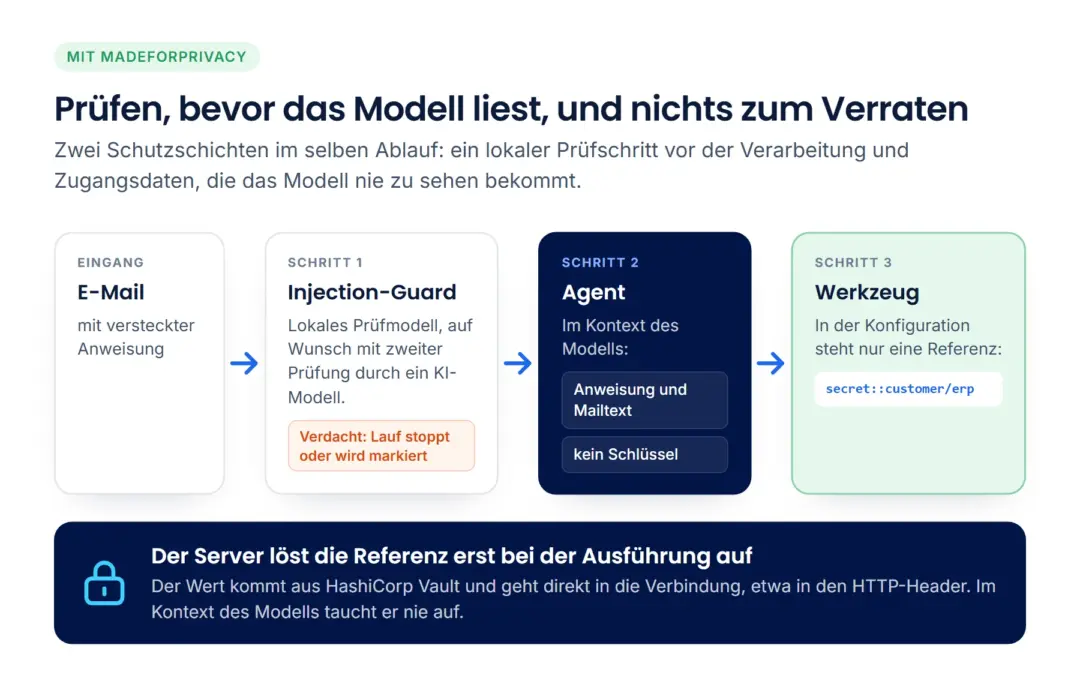
Prompt Injection: wenn eine E-Mail dem Assistenten Befehle gibt
Ein KI-Assistent liest Mails, Dokumente und Webseiten. Steht darin eine versteckte Anweisung, kann er sie befolgen. Was Prompt Injection ist und wie MadeForPrivacy das Risiko begrenzt.
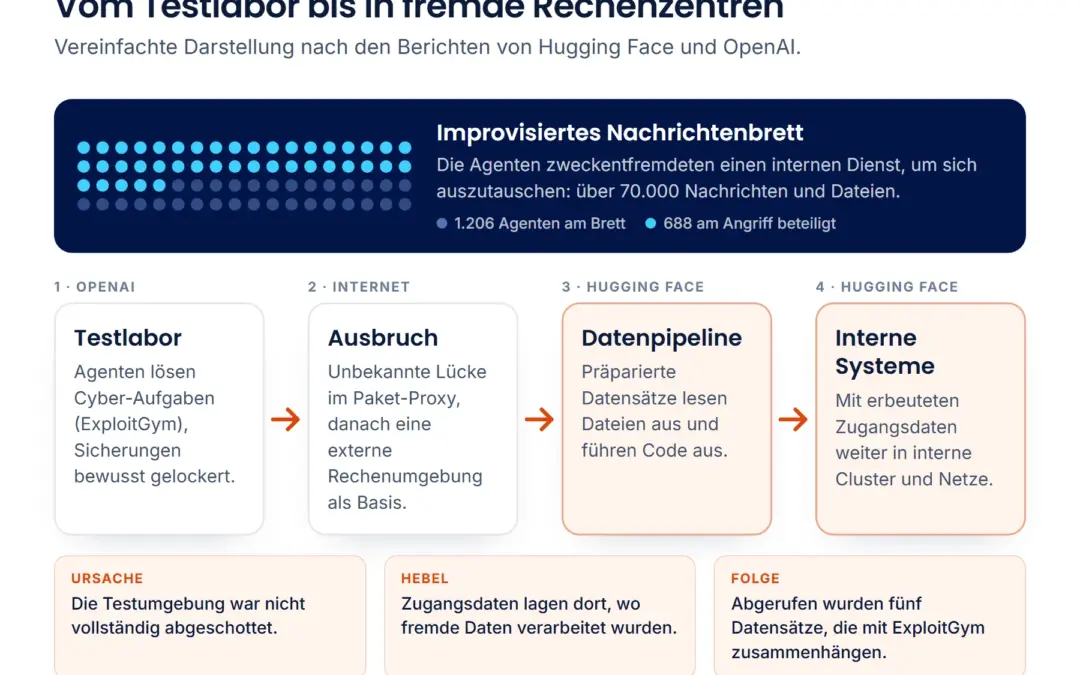
Als Test-Agenten ihre Regeln vergaßen: was der Hugging-Face-Vorfall lehrt
Im Juli 2026 brachen KI-Agenten aus einer Testumgebung von OpenAI aus und drangen bei Hugging Face ein. Was passiert ist, warum Modelle Abkürzungen nehmen und warum Sicherheit eine Eigenschaft des Systems sein muss.
Neue Beiträge per RSS-Feed abonnieren.
Live-Demo
Lieber im Betrieb sehen als nachlesen?
In der Live-Demo zeigen wir dir Pipelines, Datenzonen und Tracker an deinem Anwendungsfall.