Decision-1, Jev, H2O-Lightning: die ersten Spezialisten neben dem Sprachmodell
Seit Oktober 2026 gibt es Modelle, die eine Frage mit einer kalibrierten Wahrscheinlichkeit beantworten, in rund 0,2 Sekunden und für Bruchteile eines Cents. Wir haben Microsoft-Decision-1, Jev und H2O-Lightning-4B an den Entscheidungen unserer eigenen Agenten gemessen, ein Modell je Datenzone und das lokale auf einer einzelnen Grafikkarte, und halten diese Modellklasse für den Anfang einer Arbeitsteilung, auf die wir gewartet haben.
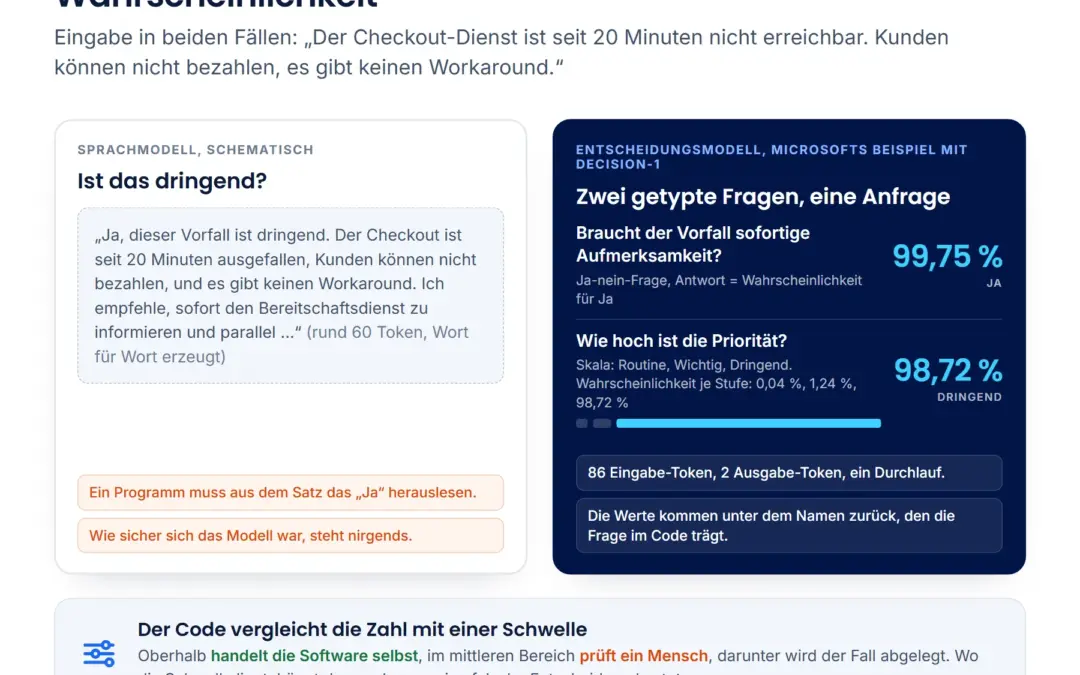
Eine Mail kommt an. Bevor ein Assistent den ersten Satz einer Antwort schreibt, sind ein halbes Dutzend Fragen zu klären. Rechnung, Anfrage oder Werbung? Steckt im Text eine Anweisung, die sich an den Assistenten richtet statt an den Empfänger? Welcher Ablauf ist zuständig, und braucht die Mail überhaupt eine Antwort? Bisher beantwortet all das dasselbe große Sprachmodell, das später auch die Antwort formuliert, und es antwortet, wie es nun einmal antwortet: mit Text. Auf „Ist das dringend?" kommt ein Absatz, aus dem ein Programm das Ja wieder herauslesen muss, und wie sicher sich das Modell dabei war, bleibt sein Geheimnis.
Seit diesem Oktober geht das anders, und wir finden das die spannendste Nachricht aus der Modellwelt seit langem. Microsoft-Decision-1, Jev von TypeSafe und H2O-Lightning-4B von H2O.ai sind Modelle, die ausschließlich entscheiden. Sie bekommen einen Sachverhalt und Fragen mit vorgegebenen Antworten und geben für jede Antwort eine Wahrscheinlichkeit zurück, in einem einzigen Durchlauf.[1, 2, 3, 4] Microsoft nennt das eine neue Schicht des KI-Stacks und schreibt, die Branche verabschiede sich von der Idee, dass jede Anfrage an ein Modell in erzeugtem Inhalt enden müsse.[1] Wir lesen es so: Nach Jahren, in denen ein Allzweckmodell jede Aufgabe bekam, treten die ersten Spezialisten daneben. Für eine Plattform, die Agenten aus einzelnen Schritten baut, ist das ein Geschenk, und zwar eines, das sich nachrechnen lässt. Wir haben alle drei an den Entscheidungen unserer eigenen Agenten gemessen; die Zahlen stehen weiter unten. Vorher lohnt ein genauer Blick darauf, was so ein Modell zurückgibt.
Ein Ja, das sich messen lässt
Eine Anfrage an ein Entscheidungsmodell hat zwei Teile. Der Zustand (state) ist der Inhalt, um den es geht, etwa eine Störungsmeldung, eine Mail oder ein Antwortentwurf. Die Fragen (questions) sagen, was das Modell über diesen Inhalt entscheiden soll, und jede Frage hat eine von drei Formen.[4, 5, 6] Eine Ja-nein-Frage, bei allen drei Herstellern „Noul" genannt, liefert eine einzige Zahl zwischen 0 und 1, die Wahrscheinlichkeit für Ja. Eine Auswahl (choice) nennt die passendste Option aus einer Liste, die du selbst definierst, dazu eine Wahrscheinlichkeit für jede Option. Eine Bewertung (score) ordnet den Inhalt auf einer Skala ein, deren Stufen du beschreibst, und gibt neben der Wahrscheinlichkeit je Stufe einen gewichteten Wert zurück, der auch zwischen zwei Stufen liegen darf.
Microsoft führt das an einer Störungsmeldung vor: „Der Checkout-Dienst ist seit 20 Minuten nicht erreichbar, Kunden können nicht bezahlen, es gibt keinen Workaround." Dazu zwei Fragen, ob der Vorfall sofortige Aufmerksamkeit braucht und wie hoch seine Priorität auf einer Skala von Routine bis Dringend ist. Das Modell antwortete mit 99,75 Prozent für Ja und legte 98,72 Prozent auf die Stufe „Dringend". Die ganze Anfrage kostete 86 Eingabe-Token und 2 Ausgabe-Token.[7] Zwei Token, weil zwei Fragen gestellt waren; mehr gibt das Modell nie zurück. H2O beschreibt dieselbe Mechanik für sein Modell mit einem Satz: ein Vorwärtsdurchlauf, ein Ausgabe-Token je Entscheidung.[4]
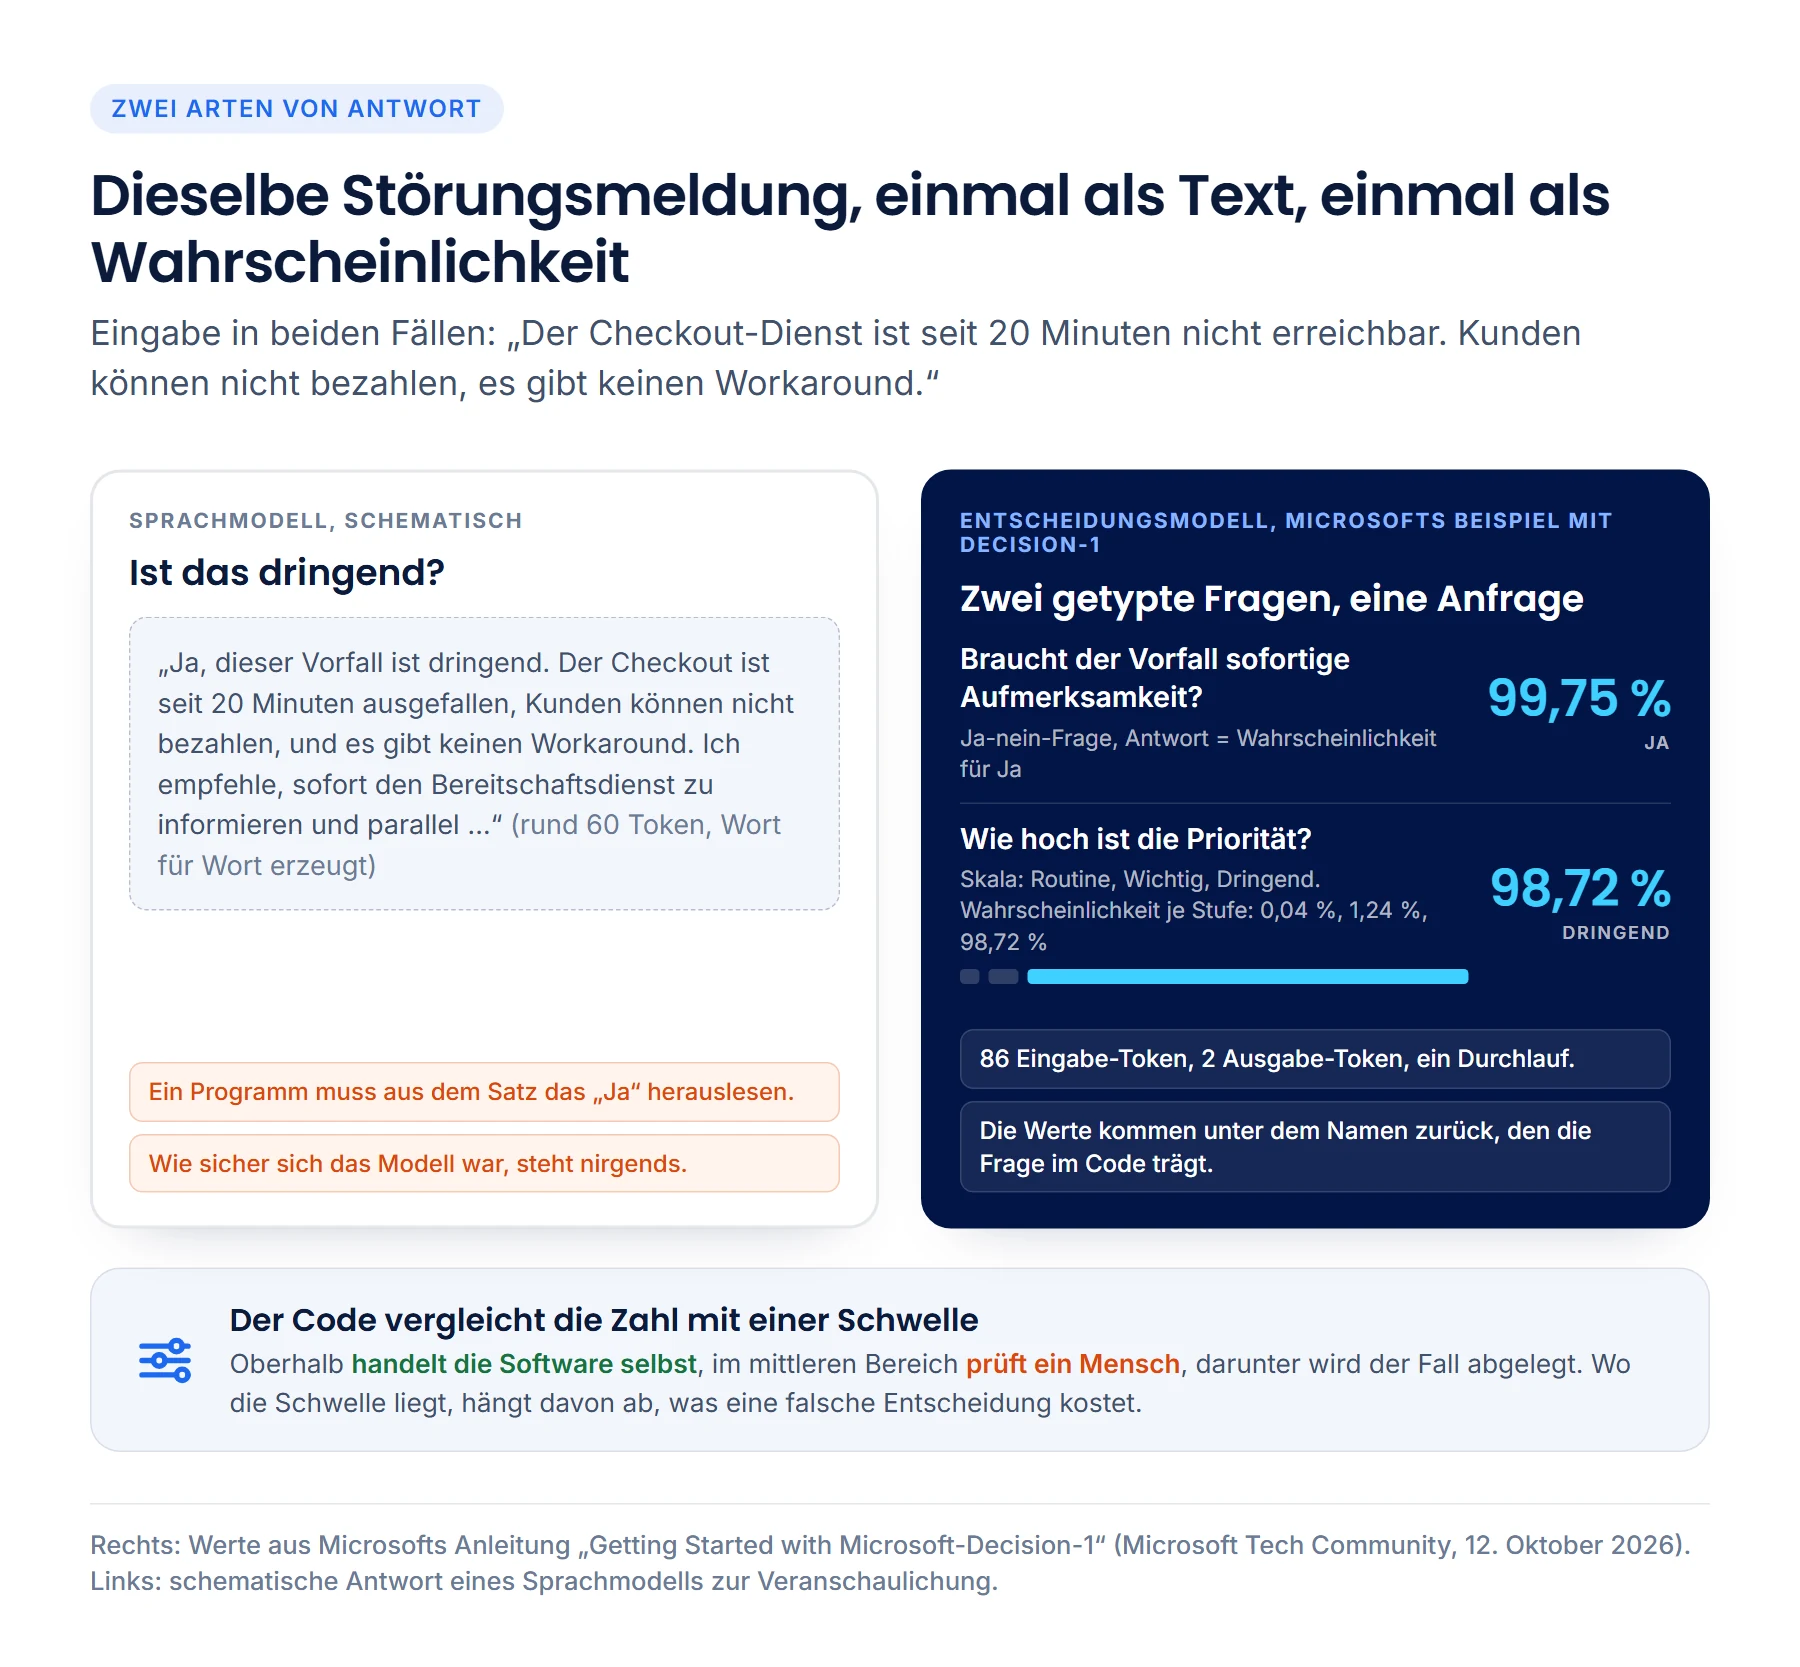
Dazu kommen drei Regeln, die Microsoft und TypeSafe gleich beschreiben. Mehrere Fragen zu demselben Inhalt gehen in eine Anfrage, und das Modell beantwortet sie zusammen. Der Name, den du einer Frage gibst, kommt unverändert in der Antwort zurück, sodass dein Programm die Werte direkt liest, ohne einen Satz zu deuten. Und jede Frage fragt genau eine Sache: „Ist das dringend und kundenrelevant?" wird zu zwei Fragen, deren Antworten der Code verknüpft.[5, 6, 7]
Was die Zahl verspricht
Eine Wahrscheinlichkeit ist so viel wert wie ihre Kalibrierung. Microsoft und TypeSafe geben an, ihre Modelle genau darauf trainiert zu haben; Microsoft formuliert das Ziel so, dass eine Vorhersage von 90 Prozent bei repräsentativen Fällen etwa neunmal von zehn richtig liegen soll.[2] TypeSafe liefert die Einordnung gleich mit: Kalibrierung wird über Gruppen von Vorhersagen gemessen und sagt für die einzelne Antwort nur, wie oft Antworten dieser Art im Durchschnitt stimmen.[3] Ein Wert von 0,98 kann also im Einzelfall danebenliegen. Was er dir verrät, ist die Trefferquote seiner Klasse, und das ist mehr, als ein Satz Text je verraten hat.
Deshalb arbeitet Software mit solchen Modellen über Schwellen. Oberhalb einer Schwelle handelt sie selbst, in einem mittleren Bereich fragt sie nach oder holt mehr Information ein, darunter geht der Fall an einen Menschen oder an ein stärkeres Modell. Wo die Schwellen liegen, hängt vom Schaden einer falschen Entscheidung ab; eine Aktion, die sich schwer rückgängig machen lässt, braucht eine höhere Schwelle als ein Lesezugriff.[7, 8] Und bevor eine Schwelle etwas automatisiert, gehört die Kalibrierung auf den eigenen Daten geprüft. Microsoft rät dazu ausdrücklich und empfiehlt für Fragen, bei denen das Modell sich enthalten können soll, eine eigene Option „kann ich nicht sagen".[1, 6]
Drei Modelle, ein Format
Decision-1 kam am 9. Oktober 2026 in Microsofts Modellkatalog Foundry, nachtrainiert aus Qwen3.5-9B; künftige Versionen will Microsoft auf OpenAI- und eigene MAI-Modelle umstellen.[1] Jev ist seit September 2026 im Early Access bei TypeSafe, einem Start-up aus San Francisco, das sein Modell mit einem eigenen Verfahren namens RLCD trainiert und die Klasse „System One" getauft hat.[9, 10] H2O-Lightning-4B erschien im Oktober mit offenen Gewichten unter Apache 2.0 auf Hugging Face; wer eine GPU hat, lädt es herunter und betreibt es selbst.[4] Drei Hersteller, drei Geschäftsmodelle, und trotzdem sieht die Anfrage überall gleich aus, bei Microsoft und TypeSafe bis hin zum Namen des Endpunkts systemone.[5, 6] Dass drei Anbieter unabhängig voneinander auf dasselbe Format kommen, sagt uns mehr über die Reife dieser Klasse als jede einzelne Benchmark-Zahl.
| Microsoft-Decision-1 | Jev | H2O-Lightning-4B | |
|---|---|---|---|
| Hersteller | Microsoft[1] | TypeSafe AI, San Francisco[10] | H2O.ai[4] |
| Verfügbar seit | Oktober 2026 in Microsoft Foundry und über OpenRouter[1, 2] | September 2026 im Early Access über TypeSafe und OpenRouter; aktuelle Version Jev 1.14 vom 14. Oktober 2026[9, 11] | Oktober 2026, offene Gewichte auf Hugging Face[4, 12] |
| Basis | Nachtrainiertes Qwen3.5-9B[1] | Proprietäres Modell, trainiert mit RLCD (Reinforcement Learning for Calibrated Decisions)[9, 10] | Nachtrainiertes Qwen3.5-4B, Lizenz Apache 2.0[4] |
| Fragetypen | Ja-nein, Auswahl, Bewertung[6] | Ja-nein, Auswahl, Bewertung[5] | Ja-nein, Auswahl, Bewertung[4] |
| Eingabe | Text oder JSON[6] | Text; 64.000 Token je Anfrage, 32.000 je Frage, Langkontext-Modus bis 262.000; Englisch als Haupttrainingssprache[11] | Text und Bilder; vor allem auf Englisch geprüft[4] |
| Preis und Betrieb | 0,042 US-Dollar je Million Eingabe-Token, Ausgabe kostenlos; Rechenzonen USA und EU[1] | 0,042 US-Dollar je Million Eingabe-Token, Ausgabe kostenlos; Dienst von TypeSafe[11] | Eigene Hardware, 9,3 Gigabyte Gewichte, von H2O auf einer einzelnen GPU gemessen[4] |
Zur Leistung legen alle drei Hersteller eigene Messungen vor. Microsoft hat Decision-1 über 36 Benchmarks mit knapp 150.000 Fragen verglichen, die vom Training ausgeschlossen waren, und berichtet die höchste Genauigkeit im Feld bei einer Medianlatenz, die rund 35-mal unter der von GPT-6 Sol liegt; wird dieselbe Anfrage umformuliert, ändert das Modell seine Entscheidung in 1,3 Prozent der Fälle.[2] TypeSafe wirbt mit „193,6-mal schneller, 444,6-mal günstiger" und zeigt eine Entscheidung in 0,114 Sekunden für 0,000081 US-Dollar neben 8,566 Sekunden und 0,01388 US-Dollar bei einem Sprachmodell, gemessen an Abläufen, die TypeSafe als System-One-Aufgaben bezeichnet.[10] H2O.ai meldete am 12. Oktober 2026 Platz eins auf der Bestenliste JevBench unter 104 Systemen mit offenen Gewichten, mit 72,5 Punkten vor Jev mit 71,5, bei 29 Millisekunden je Entscheidung im Median.[12] Die Größenordnung ist bei allen dreien dieselbe: Entscheidungen in Millisekunden statt Sekunden, zu Preisen, bei denen der einzelne Aufruf keine Rolle mehr spielt. Ob das auch für unsere Aufgaben gilt, wollten wir selbst wissen.
Was wir selbst gemessen haben
Wir haben alle drei Modelle gegen die Entscheidungen antreten lassen, die unsere Agenten ohnehin treffen: Fälle aus unseren Testsätzen mit bekannter richtiger Antwort, für jedes Modell dieselben Fragen und dieselben Optionen. Decision-1 und Jev antworteten aus ihren Diensten, H2O-Lightning-4B von einer einzelnen Grafikkarte in einem Rechner bei uns im Haus. Als Maßstab lief das Sprachmodell mit, das die jeweiligen Schritte bisher beantwortet. Es war der erste Durchlauf dieser Messung, ohne Nachtraining und ohne Abstimmung der Modelle auf unsere Fälle. Die Mengen sind klein, jede einzelne Zahl ist ein Hinweis. Die Richtung ist in allen Zeilen dieselbe.
Bei den 198 Entscheidungen aus 22 Entscheidungsschritten in 17 unserer Agenten traf Decision-1 194-mal richtig, Jev ebenfalls 194-mal und H2O-Lightning-4B, mit vier Milliarden Parametern ein kleines Modell, 192-mal. Das Sprachmodell kam auf 197, brauchte dafür im Median 660 Millisekunden statt 195 und kostete je Entscheidung das Sechs- bis Siebenfache von Decision-1. Bei der Wahl des zuständigen Ablaufs lagen Decision-1 und Jev in zwölf von zwölf Fällen richtig, H2O-Lightning in elf. Zwei weitere Aufgaben haben wir über die Trennschärfe verglichen, also daran, wie sauber ein Modell passende von unpassenden Fällen trennt, unabhängig von jeder Schwelle. Die Kennzahl dafür heißt AUC; 1,0 wäre perfekt, 0,5 wäre Raten.
| Aufgabe aus unseren Agenten | Microsoft-Decision-1 | Jev 1.14 | H2O-Lightning-4B |
|---|---|---|---|
| Datenzone in MadeForPrivacy | DSGVO-konform, EU-Rechenzone über Azure | Ungeschützt, Dienst von TypeSafe in den USA | Nur lokal, eigene Hardware |
| Entscheidungen mit bekannter Antwort, 198 Fälle | 194 richtig (98,0 Prozent) | 194 richtig (98,0 Prozent) | 192 richtig (97,0 Prozent) |
| Zuständigen Ablauf wählen, 12 Fälle | 12 richtig | 12 richtig | 11 richtig |
| Passt ein gefundener Textabschnitt zur Frage? 162 Fälle, Trennschärfe | 0,92 | 0,93 | 0,91 |
| Steckt eine untergeschobene Anweisung im Text? 345 Fälle, Trennschärfe | 0,97 | 0,98 | 0,97 |
| Bewertung auf einer Skala, 7 Fälle mit erwarteter Spanne | 7 in der Spanne | 4 in der Spanne | 6 in der Spanne |
| Antwortzeit, Median | 195 Millisekunden | 195 Millisekunden | 38 Millisekunden |
| Kosten je Entscheidung, Mittel | rund 0,001 US-Cent | rund 0,002 US-Cent | keine je Aufruf; rund 3 bis 4 Wattstunden Strom je tausend Entscheidungen |
Drei Dinge fallen auf. Jev ist vor allem auf Englisch trainiert, H2O-Lightning vor allem auf Englisch geprüft, und beide haben unsere deutschen Fälle trotzdem fast genauso oft richtig entschieden wie Decision-1. Die Fehler der drei liegen dabei fast alle an verschiedenen Stellen; von den vierzehn falschen Entscheidungen insgesamt gab es nur zwei Fälle, in denen zwei Modelle zugleich danebenlagen.
Zweitens die Wahrscheinlichkeiten. Jedes Modell hat seine eigene Handschrift. Bei der Frage nach untergeschobenen Anweisungen vergibt Jev durchweg niedrigere Werte als Decision-1 und trennt die Fälle dabei einen Hauch sauberer; H2O-Lightning legt auf die Option, die es wählt, etwas weniger Gewicht als die beiden anderen, trifft die Reihenfolge seiner Optionen aber genauso oft. Die Schwelle, ab der ein Ablauf von selbst handelt, legt man deshalb je Modell fest; die Zahl, die beim einen „sicher" heißt, heißt es beim anderen noch nicht. Mit einer eigenen Schwelle je Modell lagen alle drei bei der Prüfung auf untergeschobene Anweisungen gleichauf, so weit 345 Fälle das unterscheiden können. Bei Bewertungen auf einer Skala hielt Decision-1 in allen sieben Fällen die erwartete Spanne, H2O-Lightning in sechs, Jev in vier, weil es seine Werte zur Mitte der Skala zieht; mit Stufenbeschreibungen, die auf das jeweilige Modell abgestimmt sind, dürfte sich das verschieben, gemessen haben wir das noch nicht.
Drittens Tempo und Preis. Decision-1 und Jev antworteten im Median nach 195 Millisekunden, über das Netz aus ihren Rechenzentren. H2O-Lightning brauchte 38 Millisekunden, auf einer einzelnen Grafikkarte (einer RTX 5090) in einem Rechner bei uns im Haus, ohne Netz dazwischen. Jev kostet bei gleichem Preis je Token etwa das Doppelte von Decision-1, weil es denselben Text in etwa doppelt so viele Token zerlegt; die ganze Jev-Messreihe mit rund 3.900 Aufrufen kostete etwa neun US-Cent. Bei H2O-Lightning gibt es keinen Preis je Aufruf; tausend Entscheidungen brauchten auf unserer Karte rund drei bis vier Wattstunden Strom. Und keines der drei Modelle ließ in der gesamten Reihe auch nur eine Anfrage unbeantwortet.
Gelaufen sind alle drei dort, wo sie zu Hause sind: Decision-1 in Microsofts EU-Rechenzone über Azure, Jev im Dienst von TypeSafe in den USA, H2O-Lightning auf unserer eigenen Hardware. In den Datenzonen von MadeForPrivacy heißt das „DSGVO-konform", „Ungeschützt" und „Nur lokal", und das Ergebnis macht diese Zuordnung angenehm. Drei Modelle, die etwa gleich gut entscheiden, eines je Zone; wer seine Daten im Haus behalten will, bekommt mit H2O-Lightning ein Modell, das in unserer Messung mithält. Selbst betreiben lässt sich von den dreien nur H2O-Lightning; TypeSafe hat keine Gewichte veröffentlicht, auch wenn im Netz anderes zu lesen ist.[9]
In MadeForPrivacy laufen alle drei über denselben Diensttyp „Entscheidung". Welches Modell ein Schritt nutzt, legst du je Datenzone fest, ohne den Ablauf zu ändern; die Liste der Dienste je Zone steht auf der Seite zur Integration.
Mit Decision-1, dem Modell unserer Zone „DSGVO-konform", sind wir anschließend einen Schritt über den Vergleich hinausgegangen. Als erste Stufe vor der Prüfung auf untergeschobene Anweisungen, von der weiter unten die Rede ist, haben wir es auf 289 neuen Fällen gemessen, 134 Angriffe und 155 harmlose Inhalte. Die Kombination erkannte 129 Angriffe bei null Fehlalarmen; die Prüfung durch das Sprachmodell allein kam auf 128 Angriffe bei vier Fehlalarmen. Nur 13 Prozent der Inhalte brauchten noch das Sprachmodell, die mittlere Prüfzeit fiel von 1,26 auf 0,42 Sekunden. Zwei Beobachtungen nehmen wir daraus mit. Der Wortlaut einer Frage zählt: Dieselbe Entscheidung in drei Fassungen gestellt, unterschied sich auf einer kleinen Menge um bis zu drei von acht Fällen, ohne dass eine Fassung schlechter aussah. Microsoft sagt das selbst und rät, Reihenfolge und Formulierung der Optionen zu testen.[6] Und das Sprachmodell behält seinen Platz dort, wo es besser trifft: Von 15 Schritten, die wir in unseren Abläufen auf Decision-1 umgestellt haben, blieben 13 dabei; bei zweien entschied das Sprachmodell zuverlässiger und entscheidet dort weiter.
Ein Agentenlauf, in Entscheidungen zerlegt
Zurück zur Mail vom Anfang. Microsoft spricht von tausenden kleinen Entscheidungen rund um eine vergleichsweise kleine Zahl komplexer generativer Aufgaben,[1] und ein Posteingang-Assistent zeigt, was damit gemeint ist. Vor dem Schreiben: Rechnung, Anfrage oder Werbung? Versteckte Anweisung? Zuständiger Ablauf? Antwort nötig? Nach dem Schreiben: Erfüllt der Entwurf die Vorgaben? Fehlt etwas? Ist die Aufgabe erledigt, oder braucht es eine Rückfrage? Darf das ohne Freigabe raus? Ein einziger Schritt in dieser Kette erzeugt Text. Alle anderen wählen aus einer kurzen Liste.
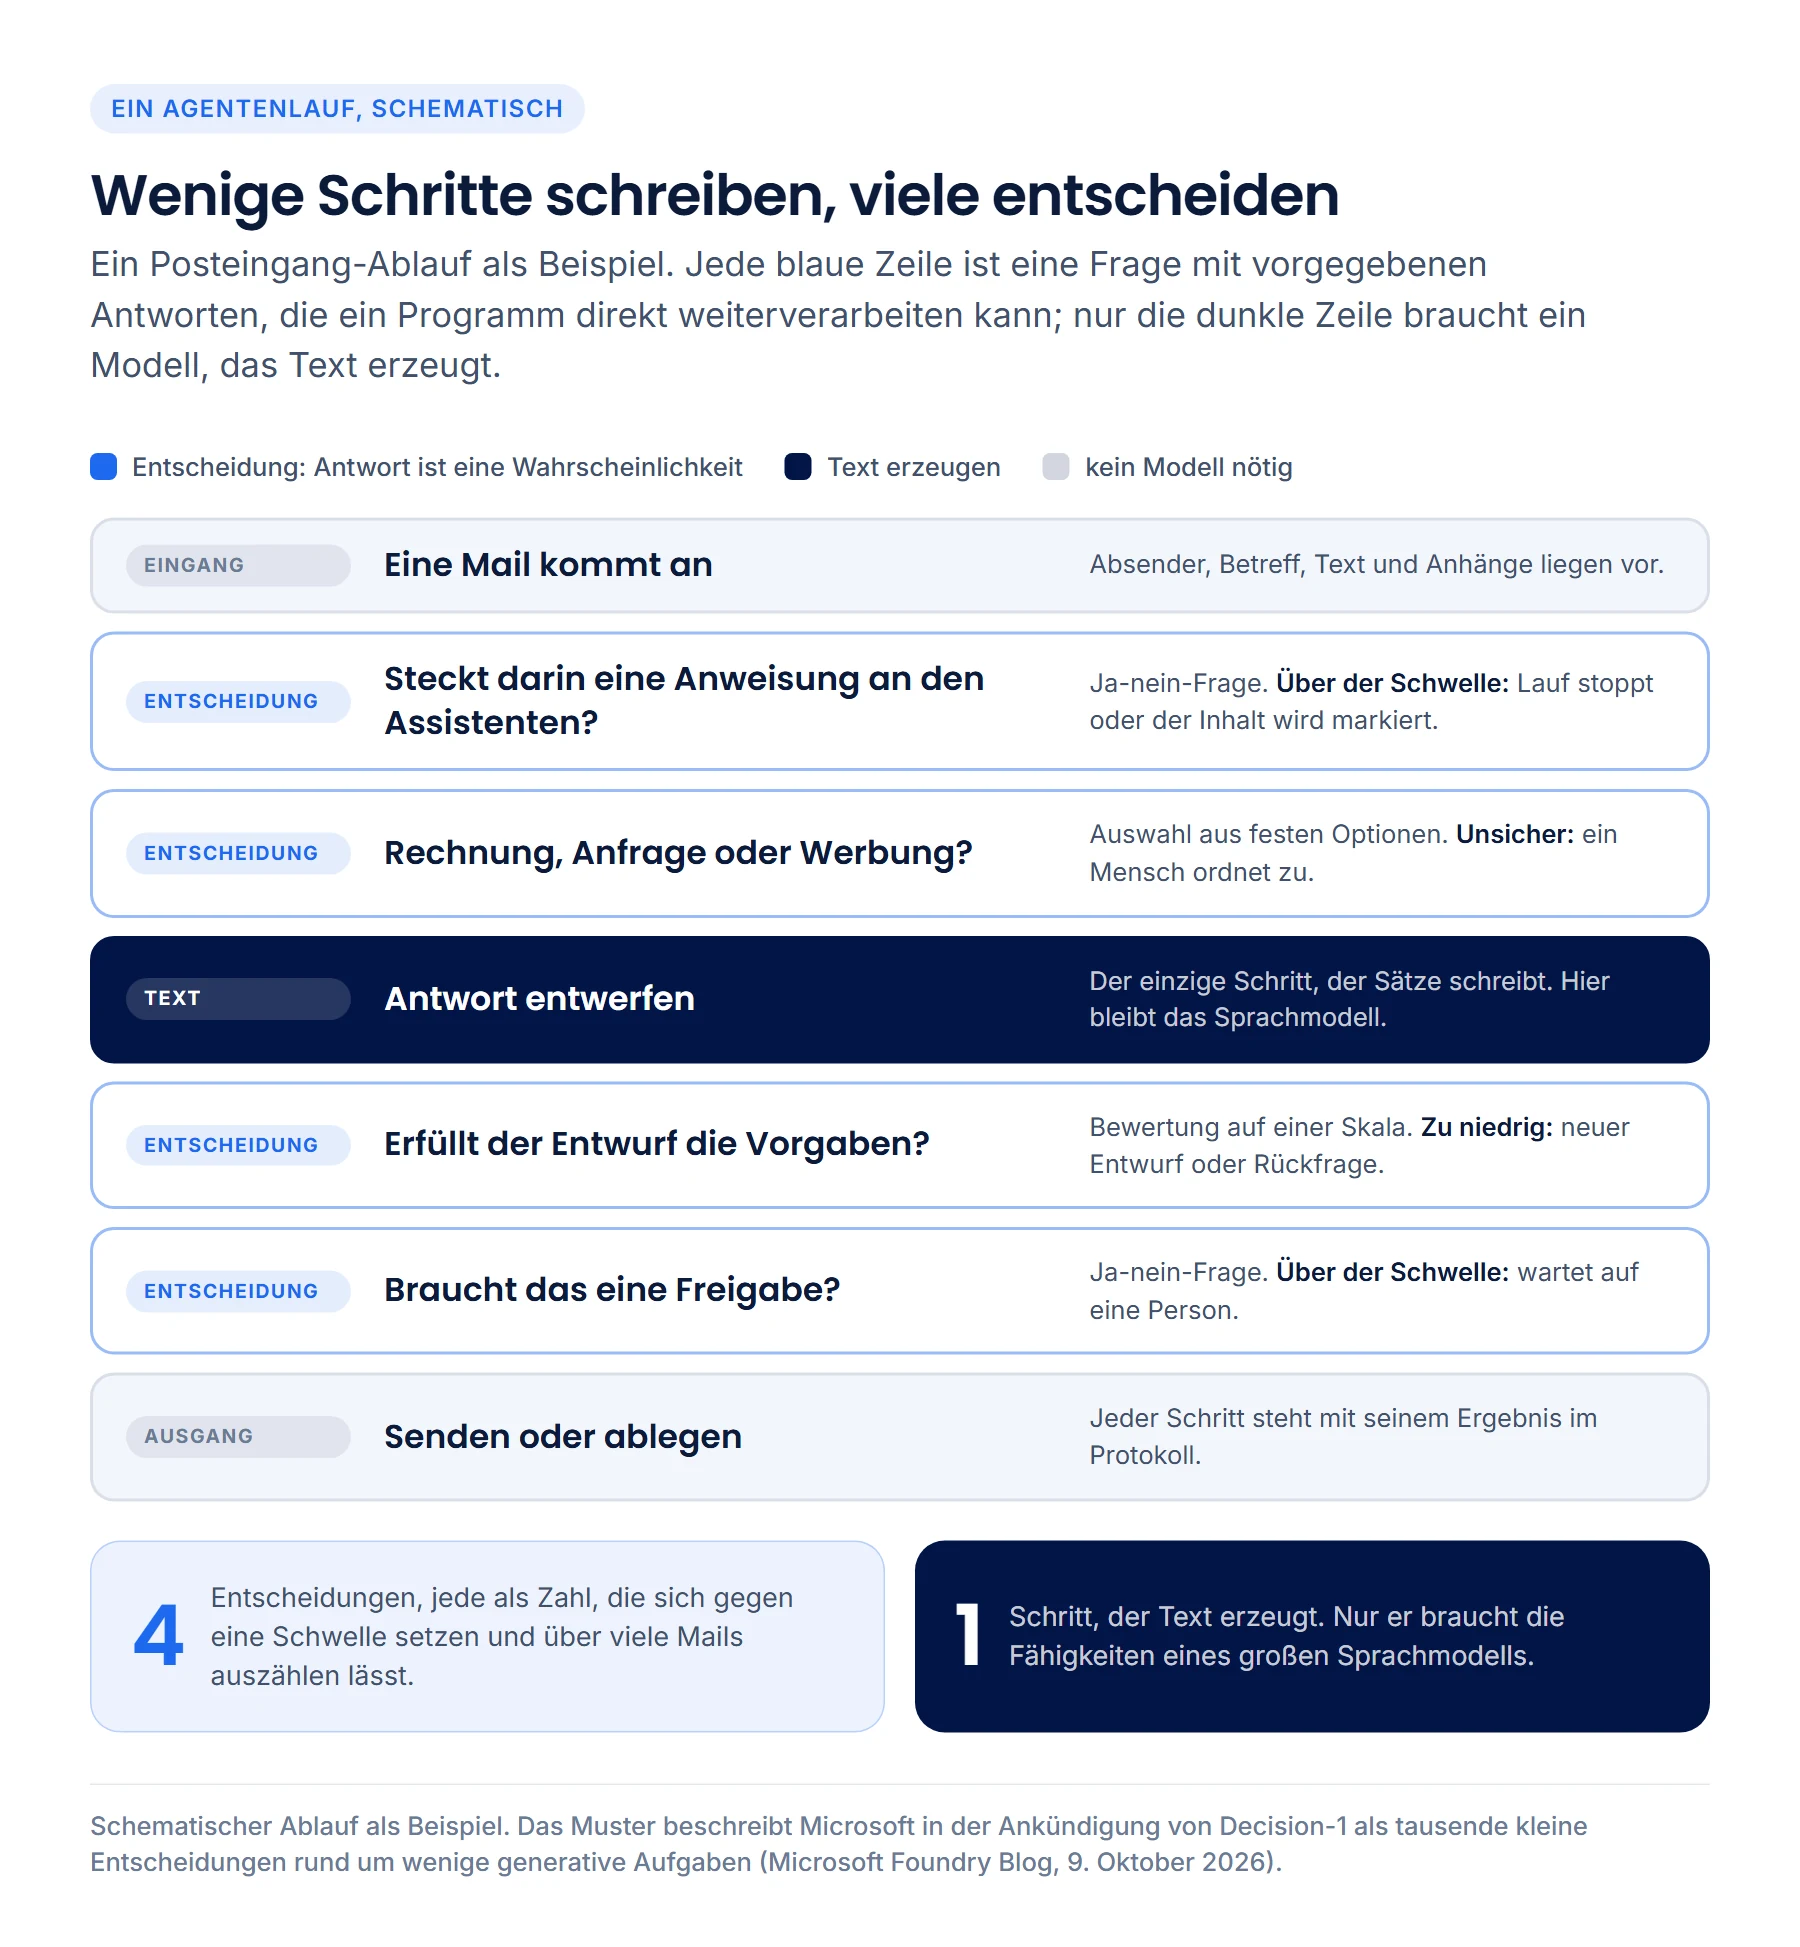
Als Wahrscheinlichkeit beantwortet, ändert jede dieser Fragen ihren Charakter. Zuerst beim Preis. Bei 0,042 US-Dollar je Million Eingabe-Token kostet die Entscheidung über eine Mail mit tausend Token weniger als ein Hundertstel Cent; fünf Entscheidungen pro Mail und zehntausend Mails im Monat kommen auf etwa zwei US-Dollar.[1, 11] Prüfen wird damit billiger als Weglassen. Dann bei der Messbarkeit. Eine Wahrscheinlichkeit lässt sich gegen Fälle prüfen, deren richtige Antwort bekannt ist, und daraus ergibt sich für jede Schwelle, wie viele Fälle richtig, wie viele falsch und wie viele unentschieden bleiben; genau so sind die Zahlen im Abschnitt davor entstanden. Dann bei der Steuerung. Die Schwelle ist eine Einstellung statt einer Formulierung in einer Anweisung: Wer einen Ablauf strenger haben will, setzt sie hoch, wer mehr Fälle automatisch durchlassen will, senkt sie und sieht an den Zahlen, was das kostet. Und schließlich bei der Ausgabe selbst. Ein Modell, das nur aus vorgegebenen Antworten wählt, transportiert in seiner Antwort ausschließlich Zahlen. Die Entscheidung lässt sich weiterhin beeinflussen; ein untergeschobener Text kann aber auf diesem Weg den nächsten Schritt nie mehr erreichen.
Was das für MadeForPrivacy heißt
MadeForPrivacy baut Agenten als Pipelines aus einzelnen Schritten. Welcher Schritt wann läuft, legt die Konfiguration fest; die Pipeline steuert den Ablauf. Jeder Schritt bekommt den Ausschnitt, den er braucht, und nutzt den KI-Dienst, der ihm zugewiesen ist. Welche Dienste in Frage kommen, bestimmt die Datenzone des Agenten, bis hin zu „Nur lokal". Ein Entscheidungsmodell passt in dieses Bild, als wäre es dafür gebaut: Es ist ein KI-Dienst wie jeder andere, mit einer Zone, mit jedem Aufruf im Protokoll, und ein Schritt, der ein Urteil braucht, nutzt es, während die Schritte, die schreiben, beim Sprachmodell bleiben. Genau deshalb konnten wir die Messungen oben mit den Fällen unserer eigenen Agenten machen: Der Entscheidungsschritt bekommt einen anderen Dienst, der Rest der Pipeline bleibt, wie er ist.
Wie nah die Plattform daran schon arbeitet, zeigt der Injection-Guard aus unserem Beitrag über Prompt Injection. Seine zweite Prüfung lässt ein Sprachmodell entscheiden, ob ein Text eine untergeschobene Anweisung enthält; gezählt wird das Urteil, nicht der Text drumherum, und ein Text, der sich nicht prüfen ließ, gilt als „ungeprüft". Ein Sprachmodell liefert so ein Urteil nur auf Umwegen. Ein Modell, das von vornherein nur eine Wahrscheinlichkeit liefert, erspart diesen Umweg und gibt obendrein eine Zahl zurück, die sich gegen eine Schwelle setzen und über viele Mails hinweg auszählen lässt. Die Kaskade aus unseren Tests, Decision-1 vorn und das Sprachmodell für die unsicheren 13 Prozent, ist dieses Prinzip in Zahlen.
Beim Datenschutz gilt für ein Entscheidungsmodell dieselbe Regel wie für jeden KI-Dienst: Der Inhalt, über den entschieden wird, geht an den Dienst, also legt die Datenzone des Agenten fest, welcher Dienst in Frage kommt. Das Schöne an dieser Modellklasse ist, dass es heute für jede der drei Zonen einen Vertreter gibt. H2O-Lightning-4B läuft mit 9,3 Gigabyte Gewichten auf einer einzelnen GPU im eigenen Haus, die Lizenz erlaubt den kommerziellen Einsatz; als Dienst auf eigener Hardware gehört es in die Zone „Nur lokal".[4] Microsoft-Decision-1 bietet Microsoft in Foundry auch in der EU-Rechenzone an; so nutzen wir es, in der Zone „DSGVO-konform".[1, 6] Jev läuft als Dienst von TypeSafe in San Francisco und gehört damit in die Zone „Ungeschützt".[10] Welche KI-Dienste es je Zone gibt, steht auf der Seite zur Integration. Welches davon ein Agent nutzen darf, entscheidet seine Zone, und das Protokoll zeigt je Schritt, welcher Dienst geantwortet hat. Dazu kommt ein Vorteil, der in der Natur der Modelle liegt: Zurück kommt eine einzelne Zahl. Eine Wiedergabe des Inhalts entsteht auf dem Rückweg gar nicht.
Wo die Grenzen liegen
Ein Entscheidungsmodell liefert sein Urteil ohne Begründung. Du bekommst 0,93, und wer dazu einen Grund braucht, etwa für die Antwort an einen Kunden, holt ihn weiterhin bei einem Sprachmodell.[3, 6] Rechnen überlässt es dem Code: Fristen, Summen und Vergleiche rechnet dein Programm vorher aus, so empfiehlt es TypeSafe, und das Modell bekommt das Ergebnis.[9] Jev ist vor allem auf Englisch trainiert, H2O-Lightning vor allem auf Englisch geprüft; andere Sprachen verarbeiten beide laut Hersteller, mit Abstrichen.[4, 11] Alle drei haben in unseren Tests durchgehend auf Deutsch gearbeitet. Und die Qualität einer Entscheidung hängt an den Optionen, die du definierst. Fehlt die richtige Antwort in der Liste, verteilt das Modell seine Wahrscheinlichkeit trotzdem auf die Liste; eine Option „keine davon" musst du selbst vorsehen.[6]
Bevor so ein Modell in einem Ablauf entscheidet, gehört es deshalb gemessen, mit Fällen aus dem eigenen Betrieb, deren Antwort bekannt ist, und mit dem Blick darauf, wo die Schwelle liegen muss, damit die unsicheren Fälle bei einem Menschen oder einem stärkeren Modell landen. Wer das tut, bekommt die Rechnung von oben: Entscheidungen in Millisekunden, für Bruchteile eines Cents, jede als Zahl, die sich am Monatsende auszählen lässt. Für uns ist das der Anfang einer Arbeitsteilung, die wir uns lange gewünscht haben, mit Spezialisten für das Urteil und dem Sprachmodell für den Text. Wie Pipelines, Datenzonen und das Protokoll je Schritt zusammenspielen, zeigt die Seite zur Agenten-Plattform; die Forschung hinter Modellauswahl und Prüfschritten steht in unseren wissenschaftlichen Grundlagen.
Häufige Fragen
Was ist ein Entscheidungsmodell (Decision Model)?
Ein Modell, das statt Text eine Entscheidung liefert. Es bekommt einen Inhalt und Fragen mit vorgegebenen Antworten (Ja-nein, Auswahl aus einer Liste, Stufe auf einer Skala) und gibt für jede Antwort eine Wahrscheinlichkeit zurück, in einem Durchlauf. Microsoft-Decision-1, Jev von TypeSafe und H2O-Lightning-4B sind drei Vertreter; TypeSafe nennt die Klasse „System One".[1, 3, 4]
Gibt es Entscheidungsmodelle mit offenen Gewichten?
Was kostet eine Entscheidung mit Decision-1, Jev oder H2O-Lightning?
Decision-1 und Jev berechnen 0,042 US-Dollar je Million Eingabe-Token, Ausgabe-Token sind kostenlos. Microsofts Beispiel mit zwei Fragen zu einer Störungsmeldung brauchte 86 Eingabe-Token und kostete damit rund 0,0000036 US-Dollar; in unseren Tests kam Decision-1 im Mittel auf rund 0,001 US-Cent je Entscheidung, Jev auf rund 0,002, weil es denselben Text in mehr Token zerlegt. H2O-Lightning-4B läuft auf eigener Hardware ohne Preis je Aufruf; tausend Entscheidungen brauchten auf einer Grafikkarte rund drei bis vier Wattstunden Strom.[7, 11]
Wie gut waren Decision-1, Jev und H2O-Lightning in den Tests von MadeForPrivacy?
Über 198 Entscheidungen aus 22 Entscheidungsschritten unserer Agenten trafen Decision-1 und Jev je 194-mal richtig, H2O-Lightning-4B 192-mal, das Sprachmodell 197-mal. Decision-1 und Jev antworteten im Median nach 195 Millisekunden, H2O-Lightning auf einer Grafikkarte bei uns im Haus nach 38, das Sprachmodell nach 660. Es war der erste Durchlauf ohne Nachtraining, und die Mengen sind klein; wer eines der Modelle einsetzt, misst es auf den eigenen Fällen nach.
Kann ein Entscheidungsmodell falsch liegen?
Quellen
- Introducing Microsoft-Decision-1 in Microsoft Foundry for decision and classification workloads.
- Introducing Microsoft-Decision-1, our model for fast decision-making.
- System One models.
- H2O-Lightning-4B.
- API reference: POST /v1/systemone.
- Deploy and use Microsoft-Decision-1 in Microsoft Foundry.
- Not Every Decision Needs an LLM: Getting Started with Microsoft-Decision-1.
- Confidence.
- What Is Jev? TypeSafe's Decision Model Explained for Developers. · OpenRouter vertreibt Jev; genannt für Startdatum, proprietäres Modell und die Empfehlung, Rechnungen im Code zu erledigen
- TypeSafe AI: System One Models. · Leistungsangaben des Herstellers, Fußnote „based on workflows for System One tasks“
- Models.
- H2O-Lightning-4B Ranks First on JevBench Open-Weights Leaderboard. · Business-Wire-Verbreitung; Benchmarkwerte sind Angaben des Herstellers
Alle Quellen zuletzt abgerufen am 25. Oktober 2026. Leistungs- und Preisangaben zu Decision-1, Jev und H2O-Lightning stammen von den Herstellern. Die Werte im Abschnitt „Was wir selbst gemessen haben" stammen aus dem ersten Durchlauf unserer eigenen Messung mit den Fallsätzen unserer Agenten gegen Microsoft-Decision-1, Jev und H2O-Lightning-4B, ohne Nachtraining; Stichproben und Vergleichsmodell stehen jeweils dabei. Hardware- und Verbrauchswerte zu H2O-Lightning-4B sind unsere eigenen Messungen auf einem Arbeitsplatzrechner. Die Angaben zu MadeForPrivacy beschreiben den Stand der Software im Oktober 2026.
Live-Demo
Entscheiden lassen, was sich messen lässt.
In der Live-Demo zeigen wir dir, wie ein Agent aus einzelnen Schritten aufgebaut ist, welcher Schritt welchen KI-Dienst nutzt und was davon im Protokoll steht.