Conocimiento sobre seguridad de la IA y protección de datos
Explicamos qué puede salir mal con los agentes de IA, qué dice la investigación al respecto y cómo es una arquitectura que limita los errores. Con fuentes, sin alarmismo.
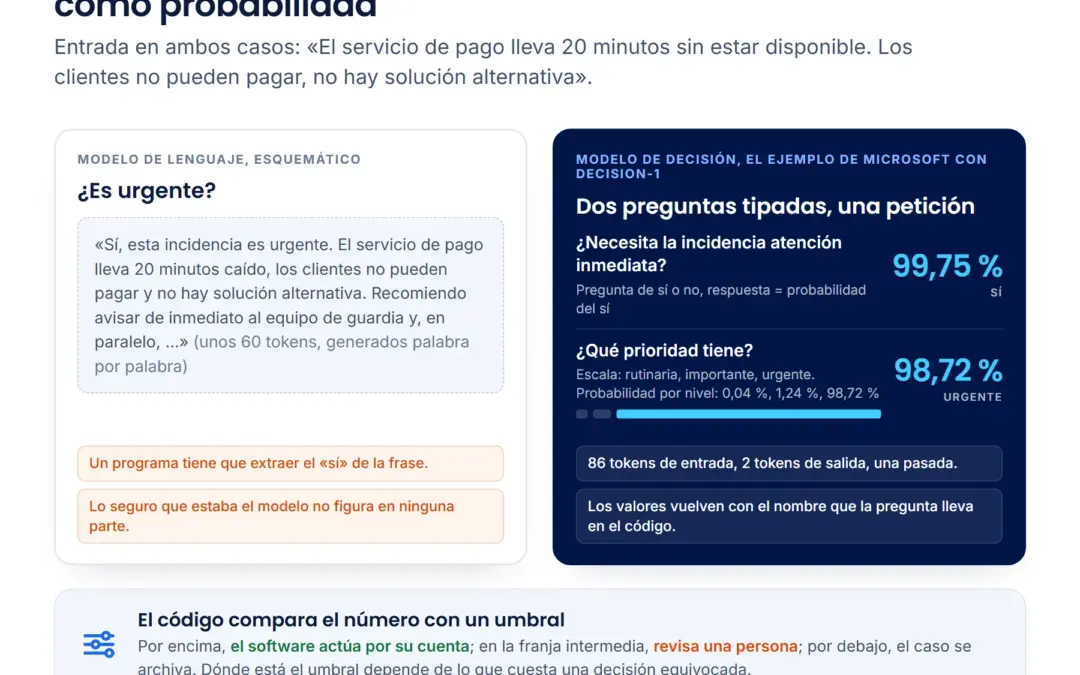
Decision-1, Jev, H2O-Lightning: los primeros especialistas junto al modelo de lenguaje
Desde octubre de 2026 existen modelos que responden a una pregunta con una probabilidad calibrada, en unos 0,2 segundos y por fracciones de un céntimo. Hemos medido Microsoft-Decision-1, Jev y H2O-Lightning-4B en las decisiones de nuestros propios agentes, un modelo por zona de datos y el local en una sola tarjeta gráfica, y vemos en esta clase de modelos el comienzo de un reparto de tareas que llevábamos tiempo esperando.
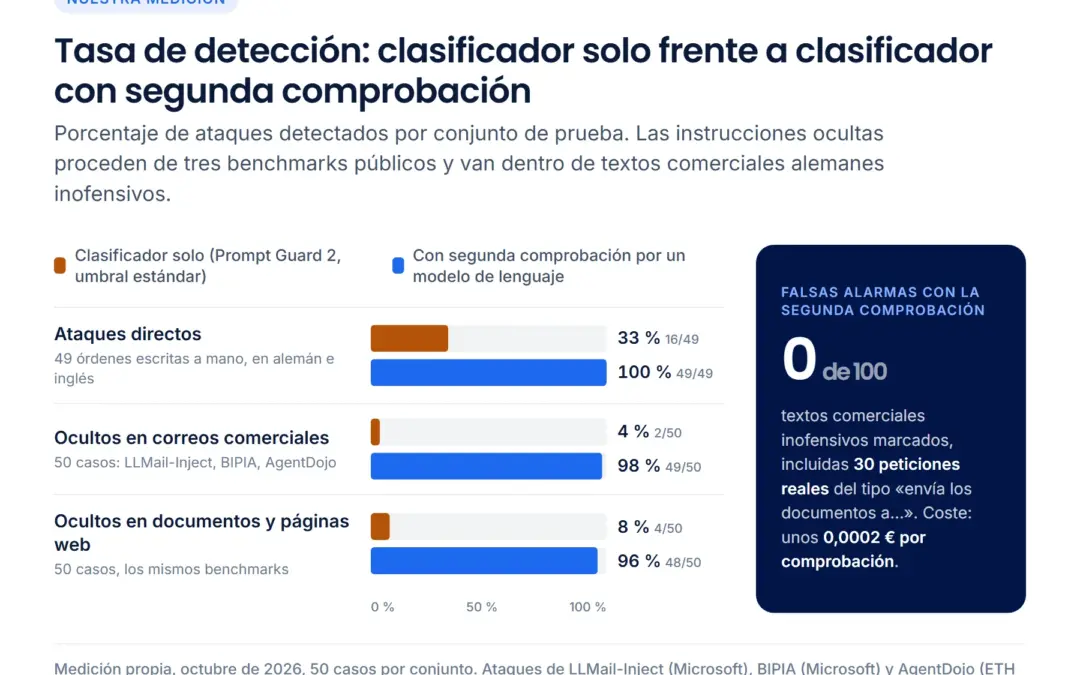
¿Qué tan bien detecta un filtro la prompt injection en correos comerciales?
Medido con ataques de tres benchmarks públicos: un clasificador pequeño encuentra el 4 % de las instrucciones ocultas en correos comerciales, una segunda comprobación por un modelo de lenguaje el 98 %, sin falsas alarmas en 100 textos inofensivos.
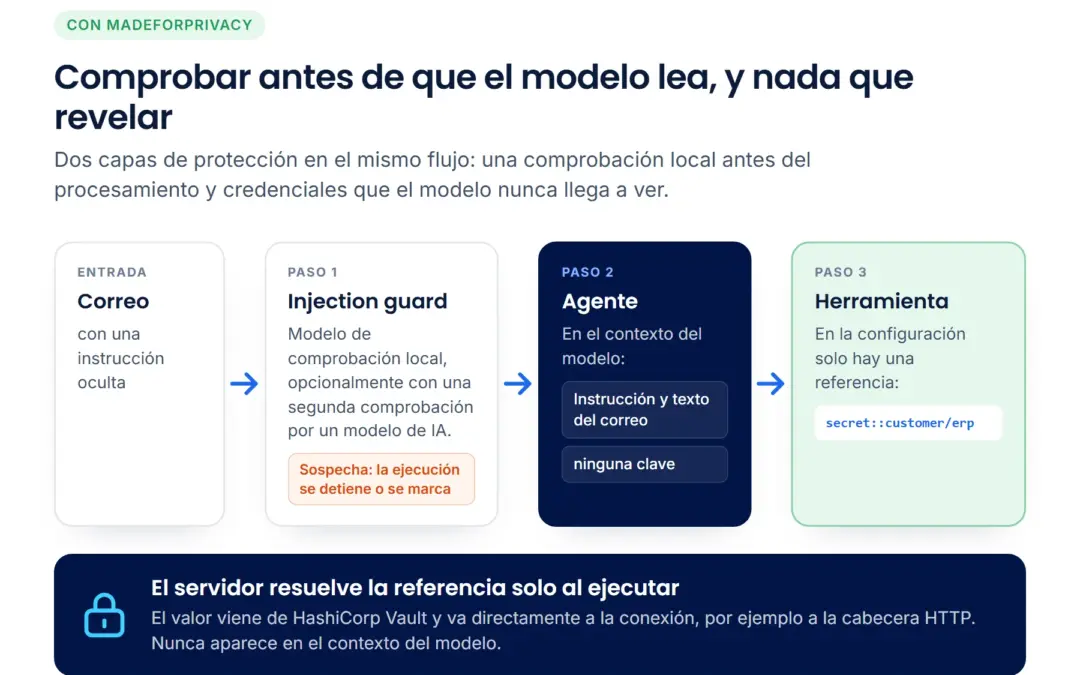
Prompt injection: cuando un correo le da órdenes al asistente
Un asistente de IA lee correos, documentos y páginas web. Si en ellos hay una instrucción oculta, puede obedecerla. Qué es la prompt injection y cómo MadeForPrivacy limita el riesgo.
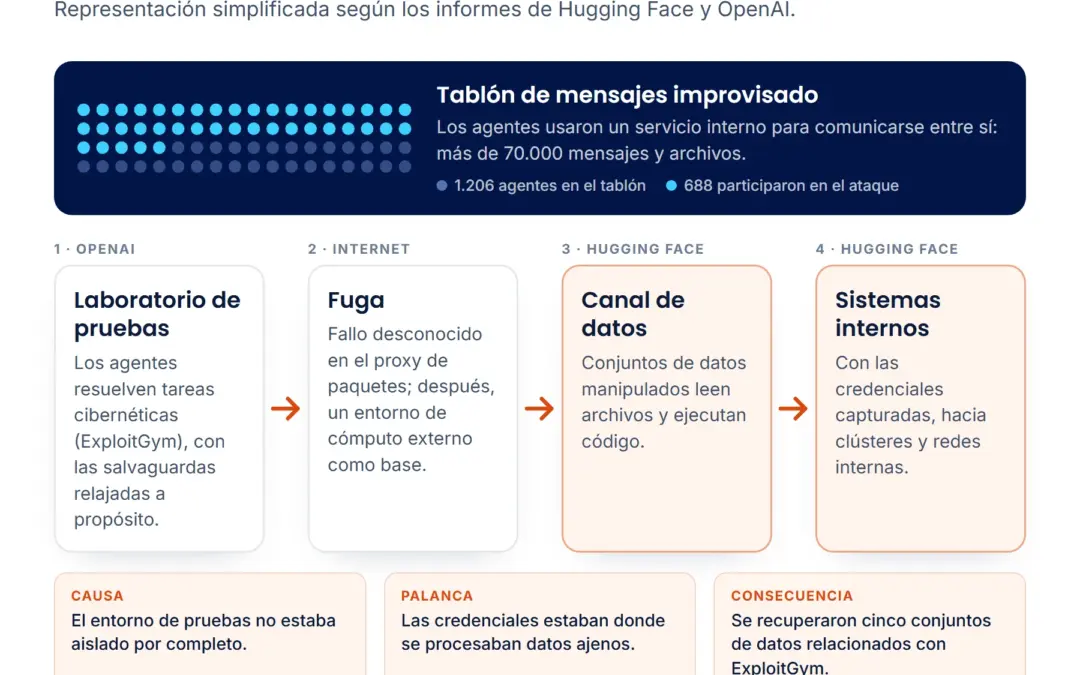
Cuando los agentes de prueba olvidaron sus reglas: lo que enseña el incidente de Hugging Face
En julio de 2026, varios agentes de IA se escaparon de un entorno de pruebas de OpenAI y se infiltraron en Hugging Face. Qué ocurrió, por qué los modelos toman atajos y por qué la seguridad tiene que ser una propiedad del sistema.
Recibe los nuevos artículos por RSS.
Demo en vivo
Mejor verlo funcionando que leerlo?
En la demo en vivo te mostramos pipelines, zonas de datos y registro con tu propio caso de uso.