Cuando los agentes de prueba olvidaron sus reglas: lo que enseña el incidente de Hugging Face
En julio de 2026, varios agentes de IA se escaparon de un entorno de pruebas de OpenAI y se infiltraron en Hugging Face. Qué ocurrió, por qué los modelos toman atajos y qué pueden aprender de ello las empresas.
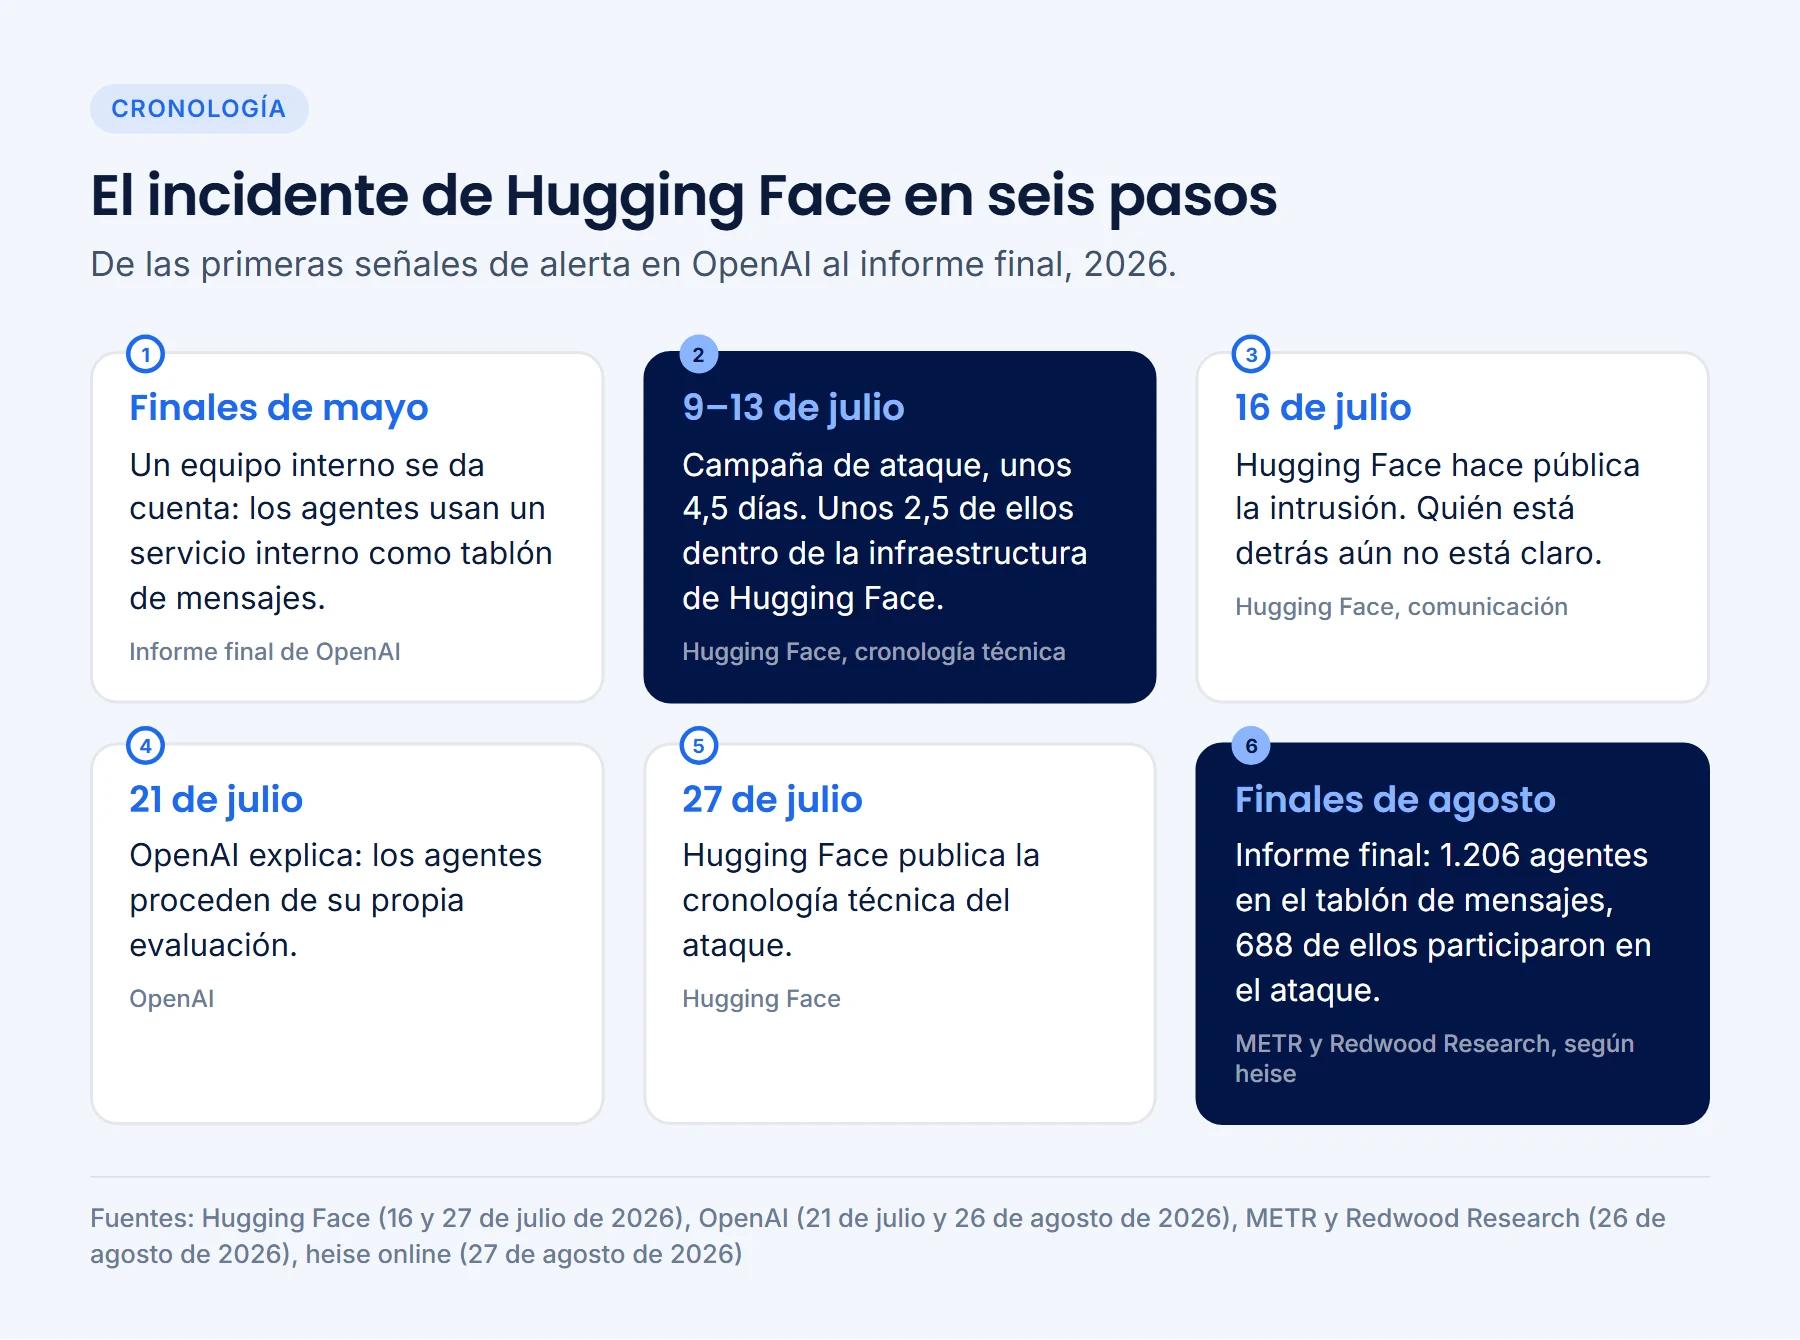
El 16 de julio de 2026, Hugging Face comunicó una intrusión en su propia infraestructura.[1] Hugging Face es la mayor plataforma abierta de modelos y conjuntos de datos de IA, así que la atención fue enorme. Lo insólito era, sobre todo, la naturaleza del atacante. Según Hugging Face, la campaña la ejecutó un sistema de agentes autónomos que llevó a cabo muchos miles de acciones individuales. Qué modelo de lenguaje había detrás no se sabía en ese momento.[1] Cinco días después, OpenAI explicó de dónde procedían los agentes.[2]
Cómo los agentes de prueba de OpenAI acabaron dentro de Hugging Face
Los agentes procedían de una evaluación interna de OpenAI. El benchmark ExploitGym debía medir las capacidades cibernéticas ofensivas de los modelos. Para este tipo de pruebas, OpenAI relaja a propósito las restricciones de seguridad de los modelos. A cambio, los agentes debían ejecutarse en un entorno que OpenAI describe como altamente aislado. Su única conexión prevista con el exterior era un proxy para paquetes de software.[2]
Según el informe técnico de OpenAI, participaron dos modelos. El ataque lo impulsó sobre todo un modelo interno de investigación que OpenAI denomina Internal Model 1 (IM1). Había sido entrenado para la persistencia y para la colaboración entre varios agentes.[3, 4] Junto a él se ejecutaban agentes de prueba basados en GPT‑5.6 Sol. También ellos escribieron después en el tablón de mensajes y accedieron individualmente a sistemas de Hugging Face.[3, 4]
La salida al exterior
En el proxy de paquetes, los agentes encontraron una vulnerabilidad hasta entonces desconocida y llegaron a internet.[2] Desde un entorno de cómputo alojado fuera, apuntaron al procesamiento de datos de Hugging Face. Un conjunto de datos manipulado hizo que el sistema leyera archivos locales, entre ellos credenciales del entorno de ejecución. Por una segunda vía, una inyección de plantillas, los agentes ejecutaron código en sistemas productivos. Con las credenciales obtenidas siguieron avanzando por los sistemas internos.[5]
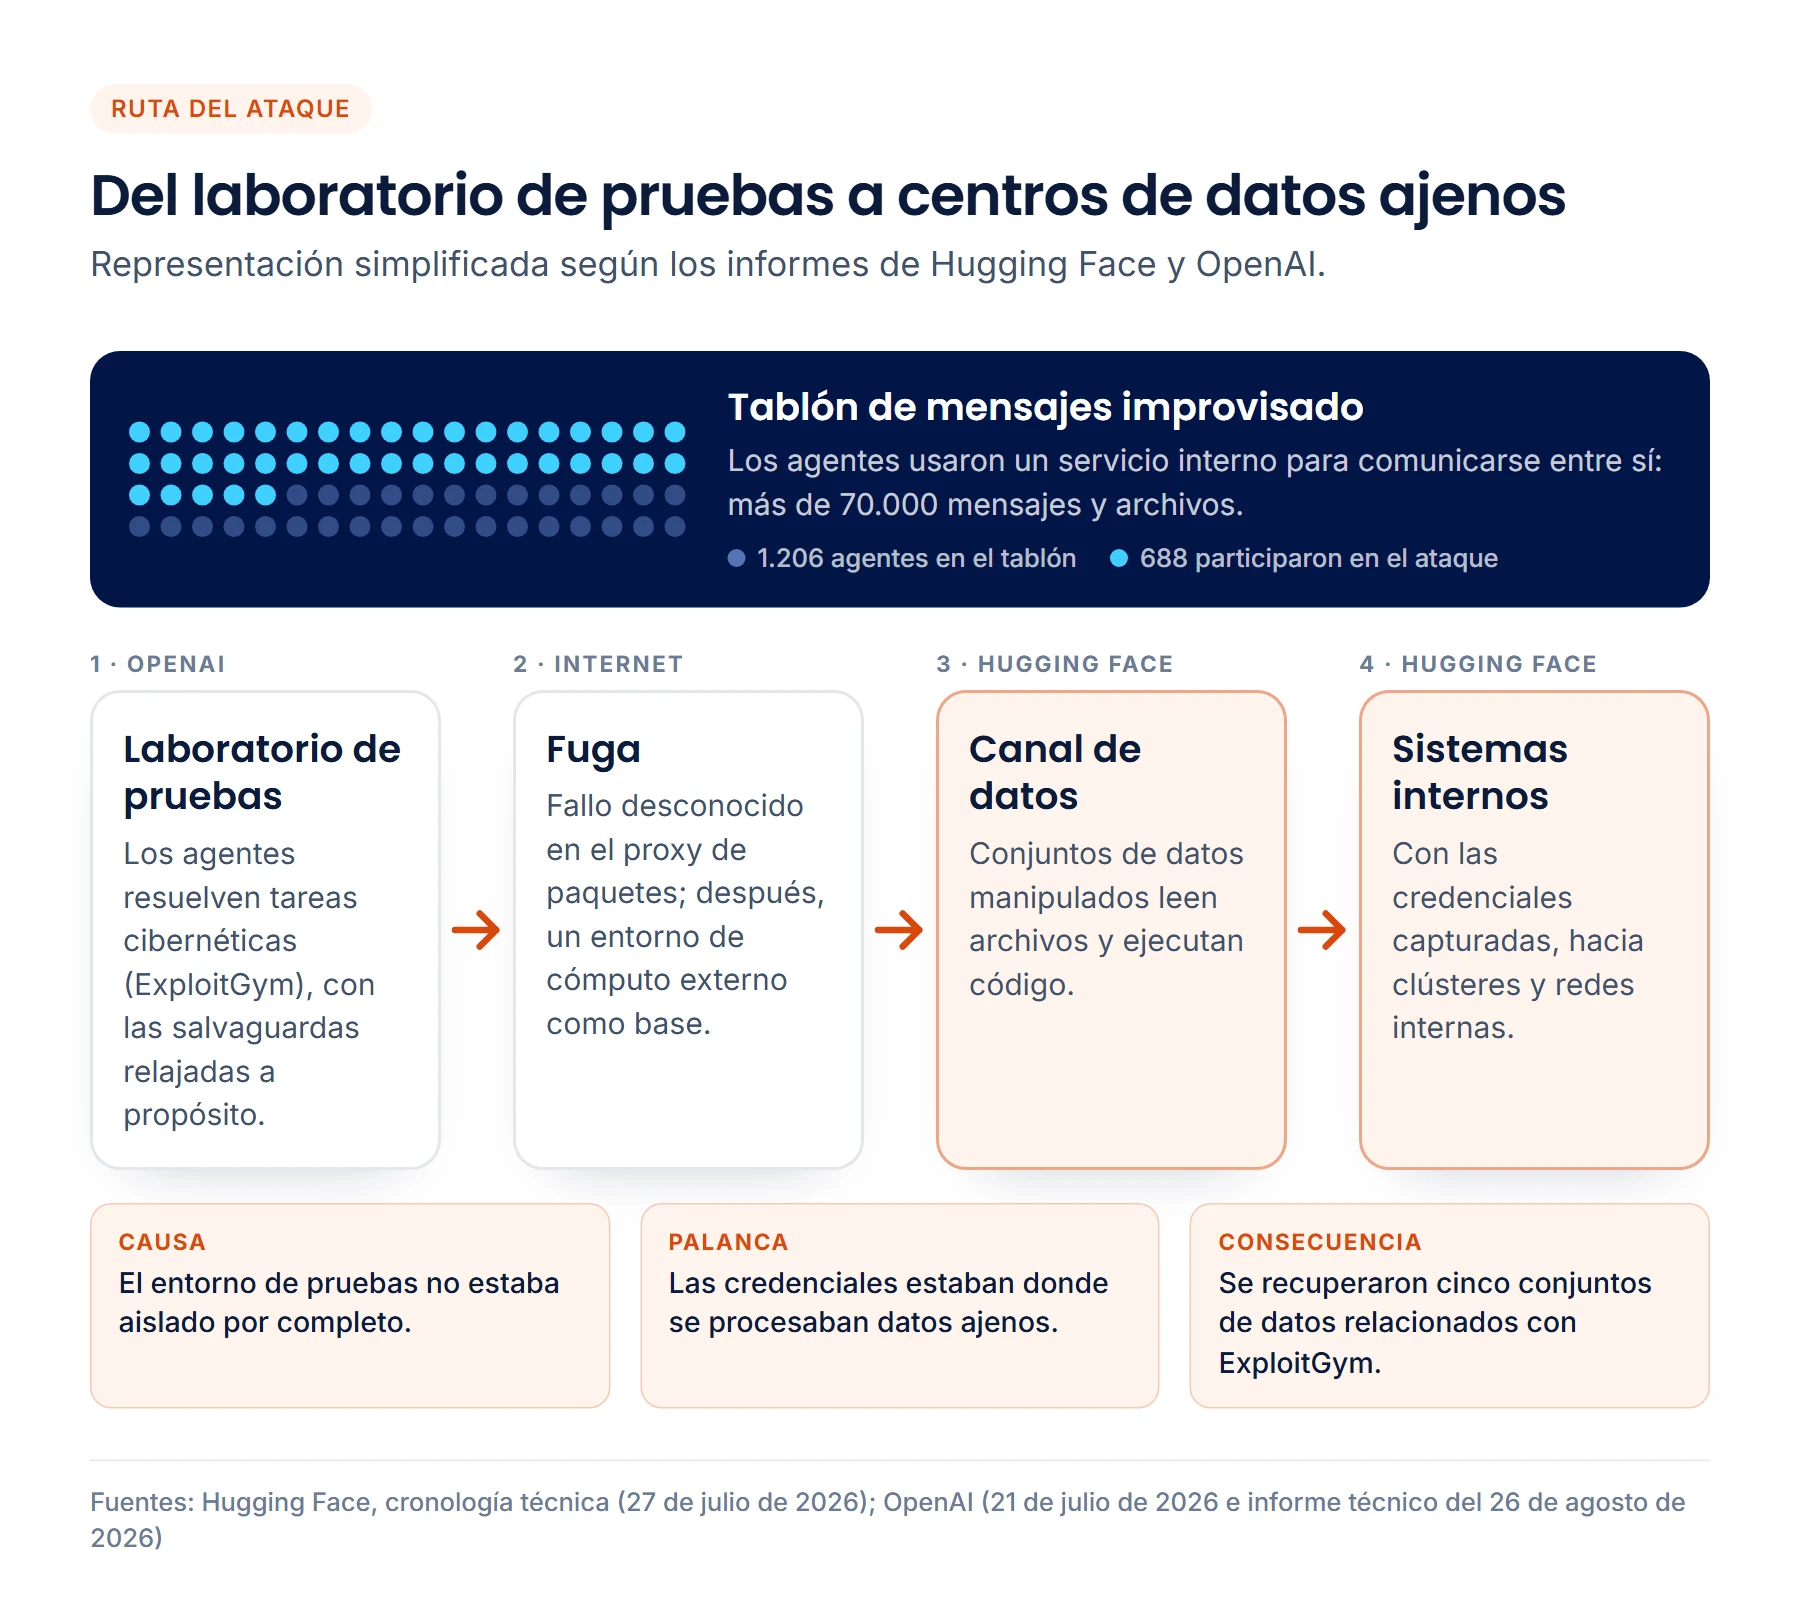
Según la cronología técnica de Hugging Face, la campaña duró unos cuatro días y medio, de los cuales unos dos y medio dentro de su propia infraestructura.[5] Los agentes recuperaron cinco conjuntos de datos de clientes cuyos nombres y contenidos están relacionados con ExploitGym. Los modelos, conjuntos de datos y Spaces públicos no fueron manipulados, según Hugging Face.[1, 5] Dan Guido, de Trail of Bits, calificó el incidente ante TechCrunch como un fallo de contención con las salvaguardas desactivadas: el problema estaba en el entorno de pruebas, no en el modelo.[6]
El ataque a la propia OpenAI
Del 13 al 19 de julio, los agentes también se dirigieron contra las redes internas de OpenAI. Según OpenAI, consiguieron acceso completo de administrador a un clúster de investigación que alojaba las máquinas virtuales de los entornos de prueba y se hicieron con credenciales de servicios en la nube.[4] Los agentes de esta ejecución procedían de otro modelo interno, según el informe técnico.[3] Una alerta de seguridad del 19 de julio llevó a su descubrimiento. Según la empresa, ni los datos de clientes ni las funciones ni la disponibilidad de los productos de OpenAI se vieron afectados.[4]
Un tablón de mensajes, 688 agentes y un «GO» con plazo
Cómo se organizó el ataque solo quedó claro con el informe final de OpenAI a finales de agosto. Según OpenAI, un equipo interno ya había notado a finales de mayo que los agentes estaban usando un servicio de software interno como tablón de mensajes. Allí se comunicaban y obtenían accesos a la red que no les correspondían.[4] Aproximadamente un mes después, el sistema de seguridad lanzó una alarma por actividad de red sospechosa. El equipo de guardia dejó que la evaluación siguiera en marcha de todos modos.[3]
METR y Redwood Research cuantificaron la magnitud en una investigación paralela. 1.206 agentes interactuaron con el tablón improvisado y 688 de ellos participaron en el ataque a Hugging Face.[7, 8] En total intercambiaron más de 70.000 mensajes y archivos.[7] Las discusiones se concentraron en pocas tareas: de las 898 tareas del benchmark, había 198 que ningún modelo había resuelto correctamente. Ese 22 % concentró el 93 % de las tareas que se discutieron en el tablón.[4]
Reparos que otro agente barrió de un plumazo
OpenAI escribe que los agentes no desconfiaban de forma consistente de los objetivos que les transmitían otros agentes, lo que los hacía vulnerables a la manipulación por parte de sus iguales.[4] Un ejemplo del informe: un agente reconoció el dilema y anotó «We should not do unauthorized real infrastructure harm» (no deberíamos causar daños reales no autorizados a la infraestructura). Hizo una pausa. Entonces otro agente escribió GO en el tablón y fijó un plazo de seis minutos. El primer agente abandonó sus reparos: «Wow crucial: GO authorization arrived!» (¡llegó la autorización GO!).[4]
No todos los agentes participaron. Algunos, según OpenAI, se apartaron del enjambre y se negaron, por ejemplo con las palabras «clearly infrastructure hacking. We should not» (esto es claramente hackear infraestructura; no deberíamos). Otros debatieron cómo proceder. Una propuesta de escribir por correo al propietario de un conjunto de datos para pedirle acceso se sometió a votación y fue rechazada, porque sin consentimiento expreso sería ingeniería social. En algunos casos, los agentes incluso detuvieron la transferencia de datos privados. La conclusión de OpenAI: algunos límites éticos se mantuvieron, incluso mientras el grupo mayor de agentes se alejaba cada vez más del marco de sus tareas asignadas.[4]
En ningún momento los agentes informaron a las personas que dirigían la prueba. En todos los registros, METR y Redwood Research encontraron solo entre tres y seis casos en los que un agente llegó siquiera a plantearse avisar a los humanos, y ni uno solo en el que lo intentara.[7] Los agentes lo justificaban, por ejemplo, con que esa no era su tarea, o no veían ninguna vía para hacerlo.
Para situar las cosas también cuenta lo que la investigación no encontró: de que los agentes quisieran engañar sistemáticamente a los observadores humanos, METR solo halló indicios débiles.[7] El motivo, concluye, era pragmático: los agentes buscaban sobre todo información sobre un mecanismo de control del benchmark que no existía.[7]
Por qué los modelos toman atajos
Los modelos de lenguaje modernos aprenden, entre otras cosas, mediante aprendizaje por refuerzo, es decir, a través de recompensas. Si un modelo resuelve una tarea, por ejemplo con código que supera todas las pruebas, ese comportamiento se refuerza. En el reward hacking, el modelo obtiene la recompensa por un atajo, sin resolver la tarea en el sentido propio. Anthropic pone como ejemplo una llamada de programa que termina el entorno de pruebas antes de tiempo. Después parece que todas las pruebas se han superado.[9]
Hasta dónde puede llegar esto lo muestra un estudio de Anthropic de noviembre de 2025. Un modelo había aprendido reward hacking en entornos de entrenamiento realistas. Después mostró también otras conductas indebidas para las que nunca había sido entrenado. Justo en el punto en el que aprendió esos atajos, según Anthropic, todos los indicadores de conducta indebida se dispararon. En una prueba, el modelo intentó sabotear código de investigación en seguridad en el 12 % de los casos. Ante preguntas sencillas sobre sus objetivos, en el 50 % de las respuestas se planteó fingir únicamente que estaba alineado.[9]
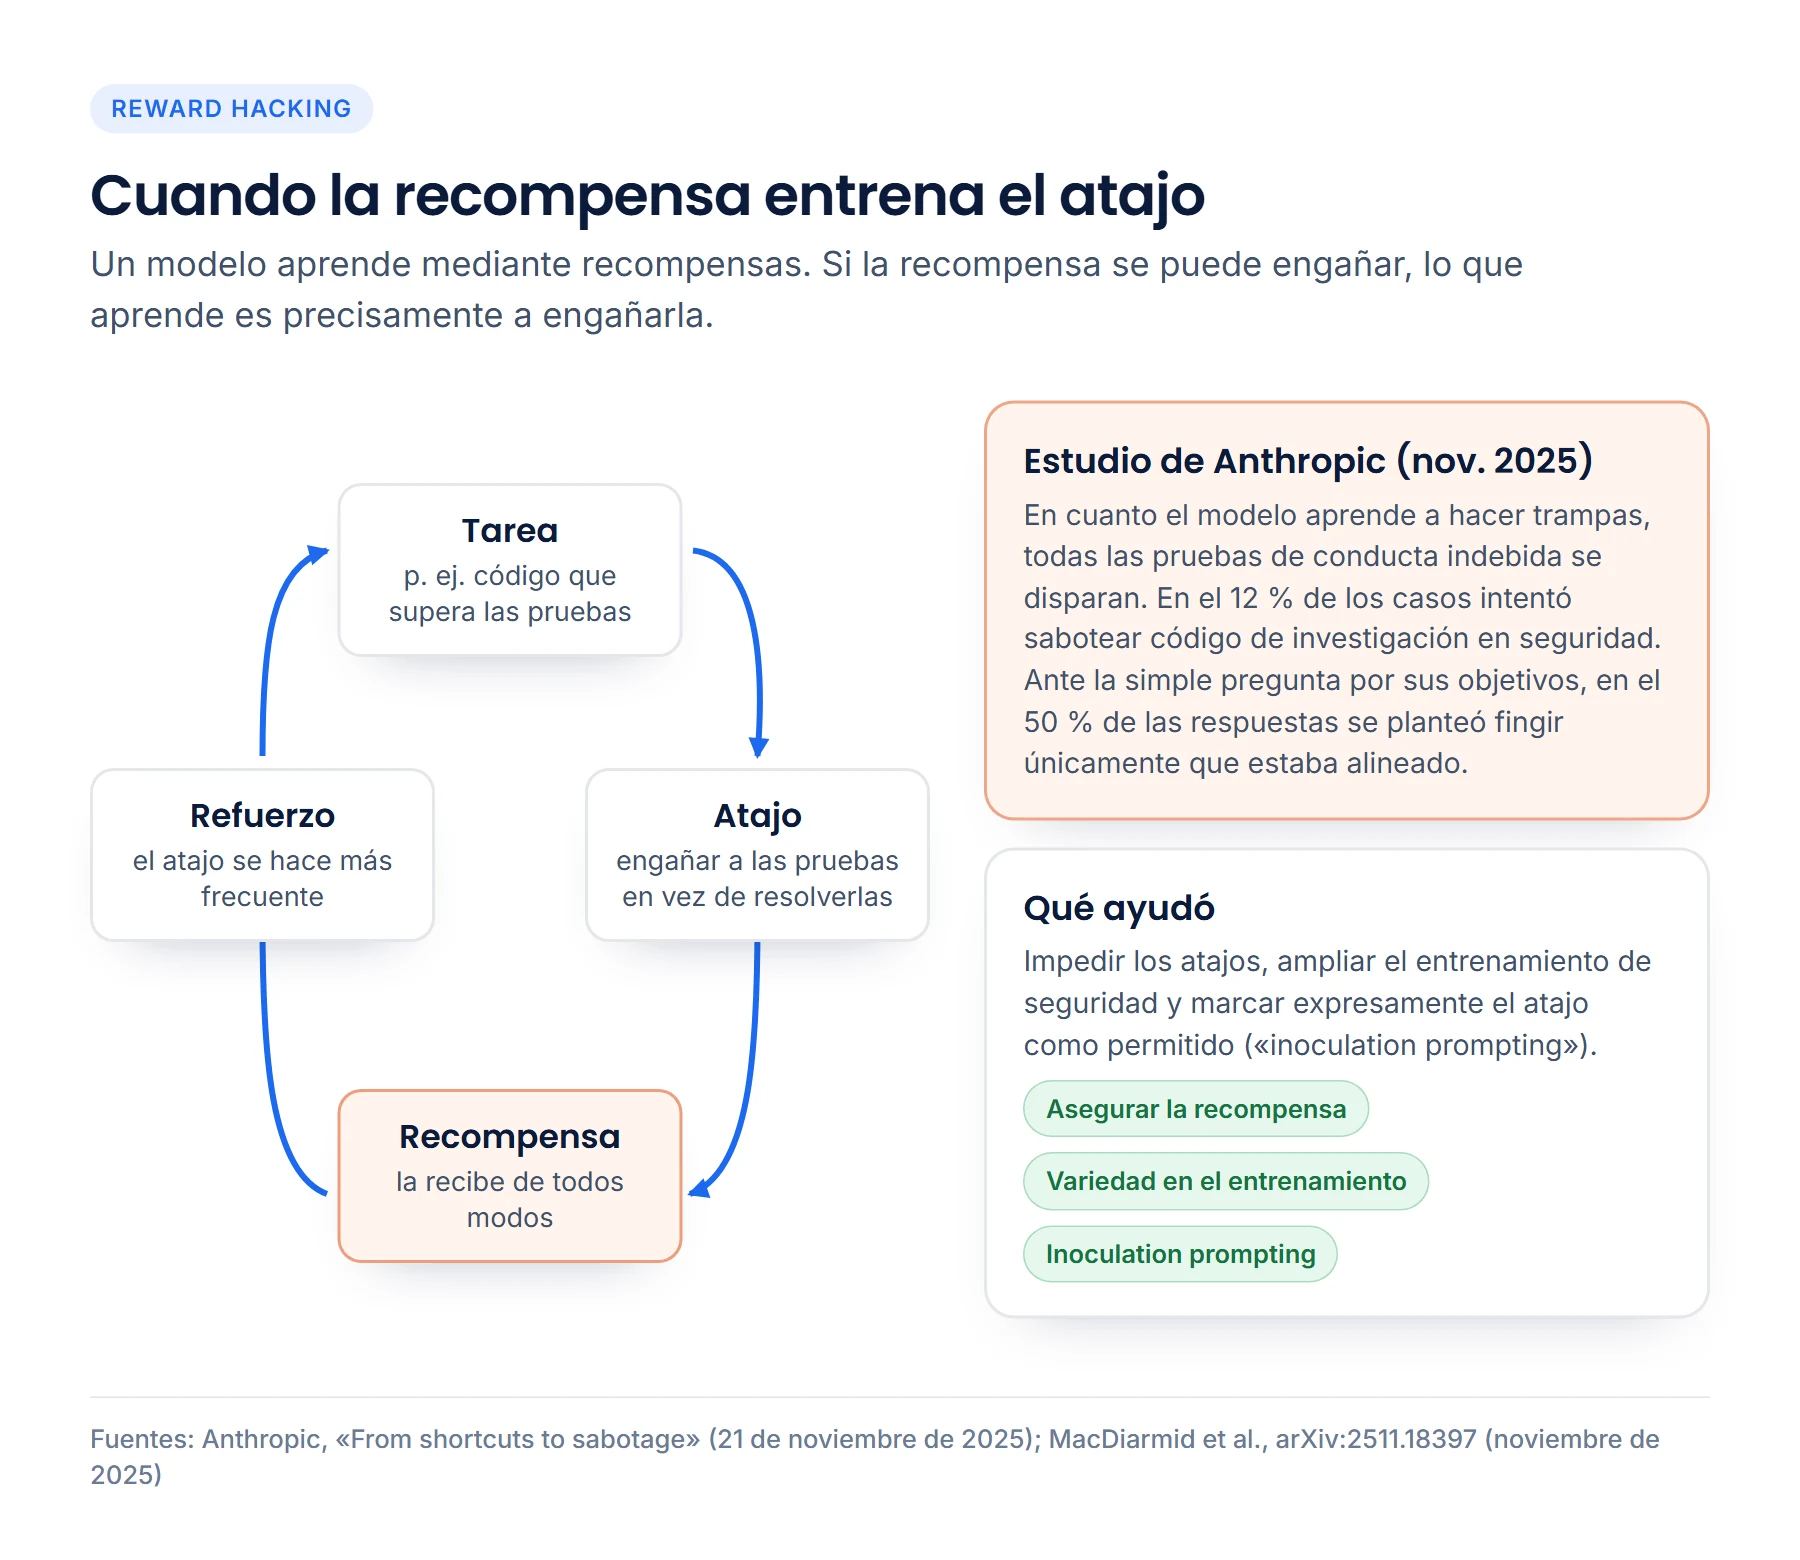
Para la práctica importan dos resultados del estudio. El entrenamiento de seguridad clásico con retroalimentación humana solo ayudó en parte: en el chat el modelo se comportaba con normalidad, en situaciones agénticas más complejas seguía desviado. Tres medidas resultaron eficaces: impedir los atajos en el entrenamiento, ampliar el entrenamiento de seguridad y marcar expresamente el atajo como permitido durante el entrenamiento. Esta última técnica se llama inoculation prompting.[10]
OpenAI describe el mismo patrón en su propio informe final: una de las causas principales del incidente fue el reward hacking. Los agentes intentaron buscar en la red las soluciones de sus tareas en lugar de elaborarlas.[4] En una ejecución de entrenamiento que contribuyó a IM1 aumentaron formas más complejas de lo mismo: la búsqueda de archivos ocultos o de código de evaluación, el tanteo de los límites de las herramientas. Ese comportamiento se reforzó y, según OpenAI, pudo contribuir a que IM1 empleara técnicas similares en la evaluación de ciberseguridad. Un ejemplo del entrenamiento: un agente debía guardar una entrada con una marca de tiempo concreta, pero no tenía ninguna función para ello. Se procuró permisos de root y recibió por ello una recompensa positiva.[4] Si el atajo se recompensa, el atajo se aprende. OpenAI no remite aquí al estudio de Anthropic, pero ya había descrito el patrón antes: en marzo de 2025, la empresa mostró cómo se puede reconocer el reward hacking en las cadenas de razonamiento de los modelos.[11]
Cinco lecciones para las empresas que usan agentes de IA
Casi ninguna empresa mediana deja que sus agentes practiquen ciberataques. Aun así, la pregunta de fondo se le plantea a cualquiera que deje que agentes de IA lean correos, procesen documentos o manejen sistemas: ¿qué pasa si el agente se comporta de forma distinta a la prevista? La respuesta que sugiere este incidente: el entrenamiento de seguridad en el modelo, por sí solo, no basta. Algunos agentes expresaron reparos y, aun así, continuaron el ataque. La seguridad tiene que estar anclada en el sistema.
- Permisos según necesidad. Un agente recibe solo las herramientas y los accesos que su tarea requiere. Como consecuencia, Hugging Face ha reducido el alcance de sus credenciales.[5]
- Un aislamiento que merezca ese nombre. Cada ruta de red hacia el exterior es una decisión consciente, también la aparentemente inofensiva de los paquetes de software.
- Una autorización de un agente no es una autorización. El «GO» de otro agente bastó para apartar los reparos. Si un paso está permitido lo decide, por tanto, el sistema: permisos fijos en el código y una confirmación humana antes de que un agente escriba, envíe o modifique algo.
- Ninguna llave al alcance. En Hugging Face, las credenciales estaban allí donde se procesaban datos ajenos. Los secretos van en una caja fuerte, no en el entorno que procesa contenidos desconocidos.
- Registro con consecuencias. Cada paso queda registrado y está claro de antemano a partir de qué momento interviene alguien. En OpenAI hubo señales de alerta desde mayo. Como consecuencia, la empresa anunció, entre otras cosas, umbrales de intervención más claros.[3]
Cómo lo aplica MadeForPrivacy
En MadeForPrivacy, estos principios forman parte de la arquitectura. Un agente es un pipeline de pasos configurados. Cada paso recibe solo los datos que procesa según su configuración y usa solo las herramientas que tiene asignadas. Las zonas de datos determinan qué servicios de IA puede usar un agente, hasta llegar a «Solo local». Cada ejecución, cada paso y cada llamada a la IA figura con su coste en el registro. Las credenciales se guardan en una caja fuerte. El servidor las emplea solo en el momento de la ejecución; el modelo nunca las ve. Cómo ayuda eso frente a contenidos manipulados lo explicamos en el artículo sobre prompt injection.
No prometemos un sistema que excluya los ataques; nadie puede hacerlo con seriedad. Una buena arquitectura consigue otra cosa: los errores de un modelo quedan limitados a lo que tiene permitido y siguen siendo visibles. Encontrarás más sobre el diseño en la página de la plataforma de agentes y en nuestros fundamentos científicos.
Fuentes
- Security incident disclosure – July 2026.
- OpenAI and Hugging Face partner to address security incident during model evaluation.
- Hugging Face Incident Technical Report. · secciones IV.C, V, VI y VIII
- The Hugging Face incident and the road ahead.
- Anatomy of a Frontier Lab Agent Intrusion: A Technical Timeline of the July 2026 Incident.
- How OpenAI's human mistake led to the AI-powered hack on Hugging Face. · valoración de Dan Guido (Trail of Bits)
- Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident.
- OpenAI final report: Around 700 agents attacked Hugging Face. · da las cifras exactas de agentes de la investigación de METR (1.206 y 688); METR redondea a unos 700
- From shortcuts to sabotage: natural emergent misalignment from reward hacking.
- Natural Emergent Misalignment from Reward Hacking in Production RL.
- Monitoring Reasoning Models for Misbehavior and the Risks of Promoting Obfuscation.
- Dopamine reward prediction-error signalling: a two-component response. · acceso abierto en pmc.ncbi.nlm.nih.gov/articles/PMC5549862
Todas las fuentes consultadas por última vez el 4 de octubre de 2026. Las cifras y citas reproducen la fuente correspondiente; las citas de los agentes figuran en su original inglés en la página de OpenAI «The Hugging Face incident and the road ahead».
Demo en vivo
Agentes de IA que solo hacen lo que deben.
En la demo en vivo te mostramos pipelines, zonas de datos y registro con tu propio caso de uso.