Decision-1, Jev, H2O-Lightning: los primeros especialistas junto al modelo de lenguaje
Desde octubre de 2026 existen modelos que responden a una pregunta con una probabilidad calibrada, en unos 0,2 segundos y por fracciones de un céntimo. Hemos medido Microsoft-Decision-1, Jev y H2O-Lightning-4B en las decisiones de nuestros propios agentes, un modelo por zona de datos y el local en una sola tarjeta gráfica, y vemos en esta clase de modelos el comienzo de un reparto de tareas que llevábamos tiempo esperando.
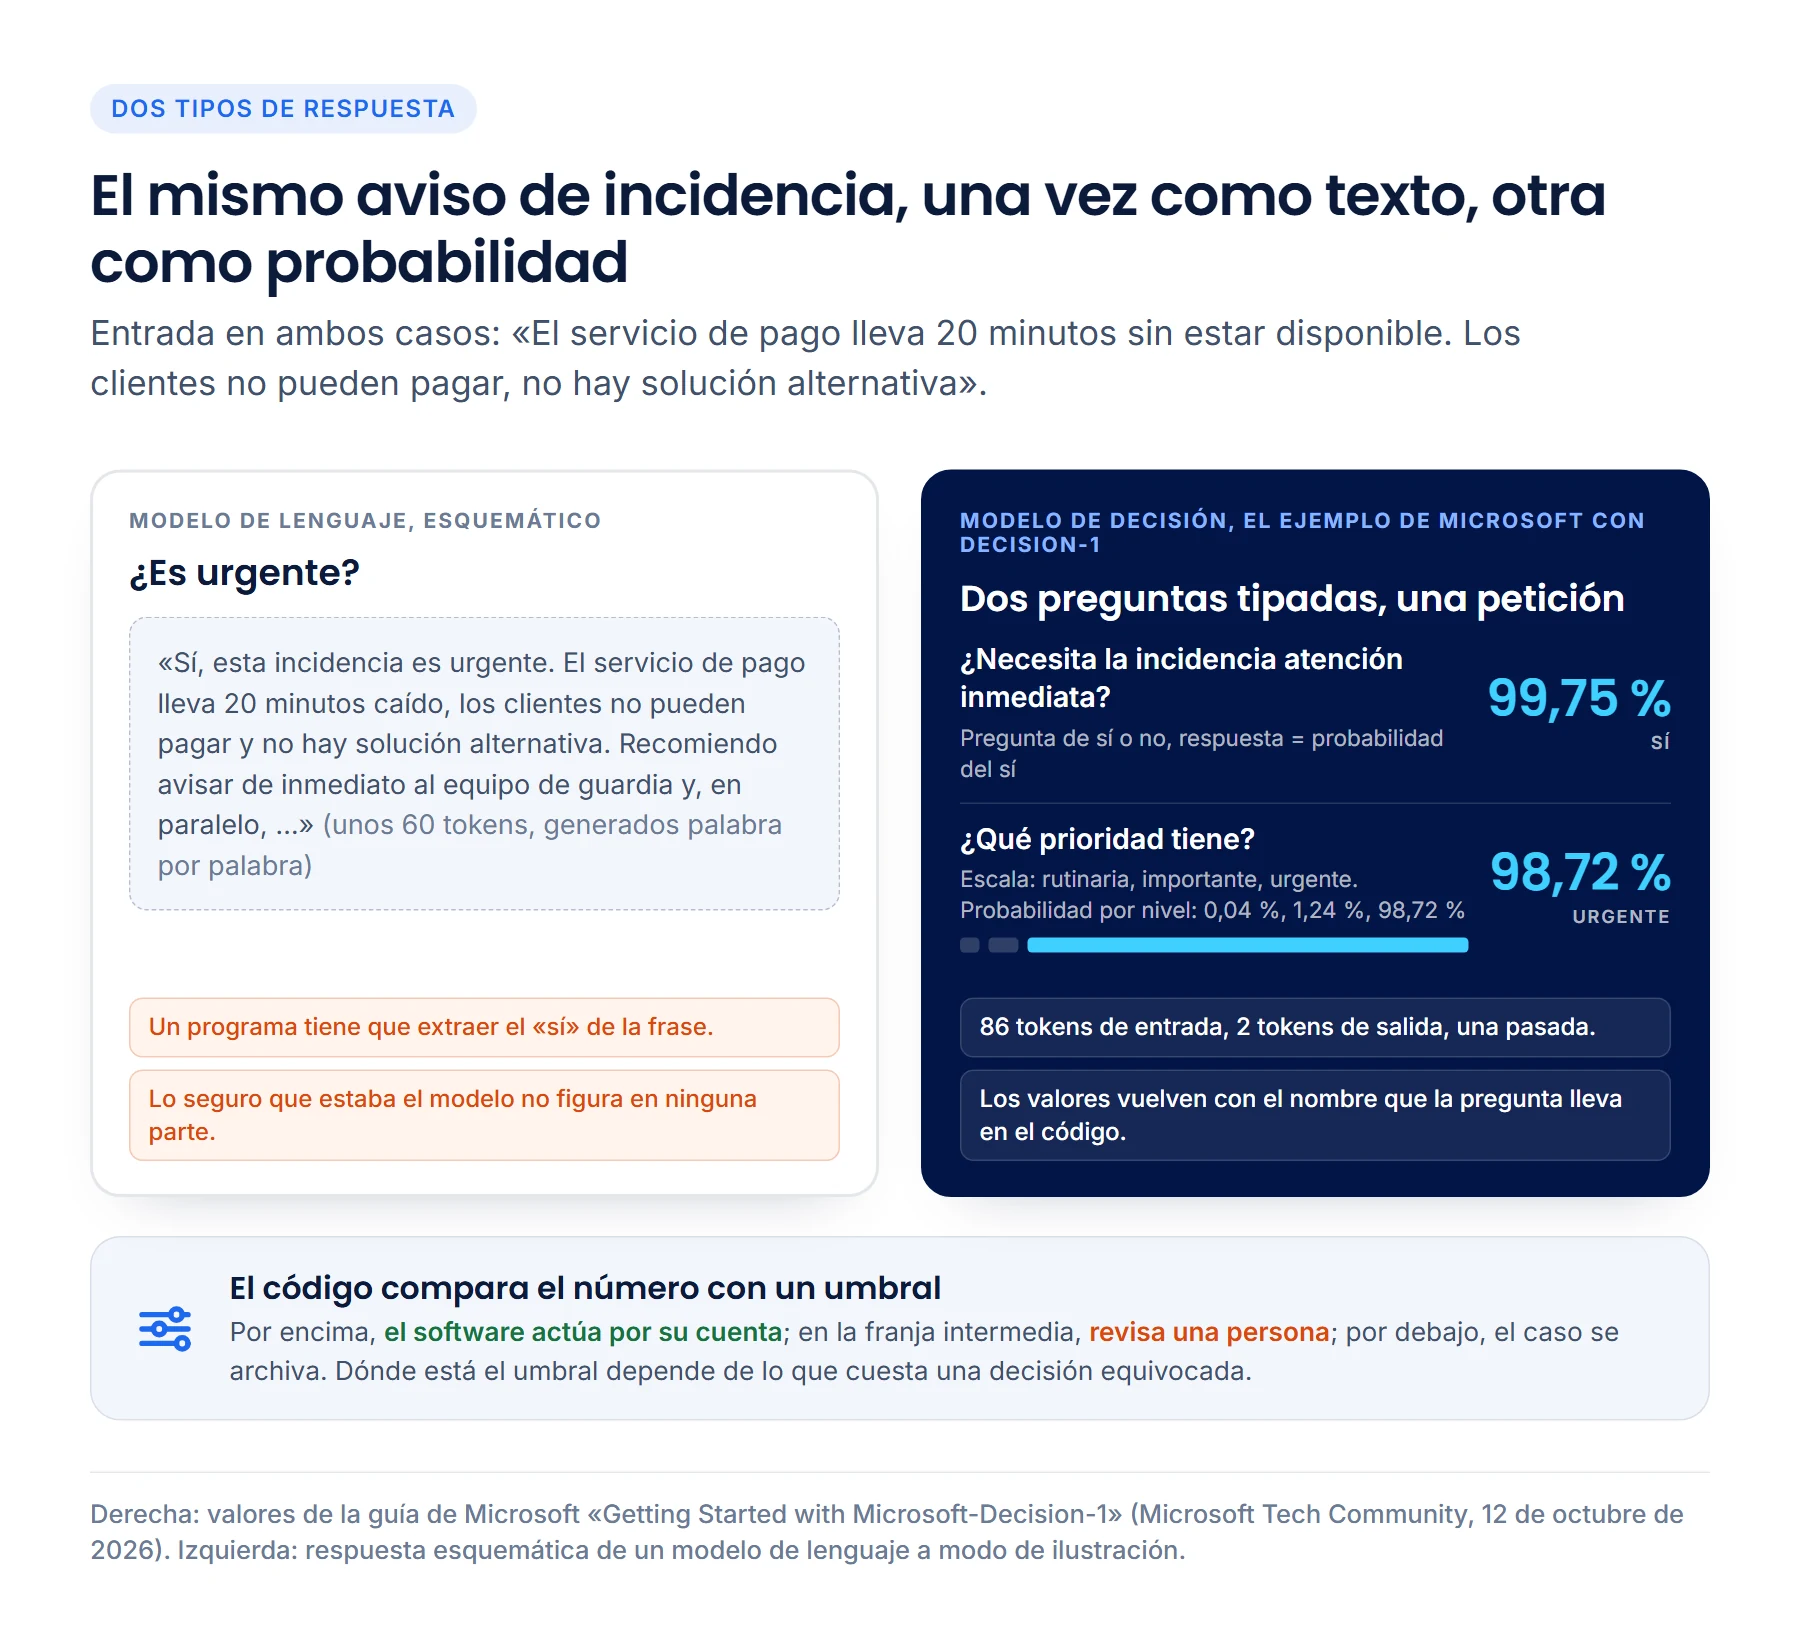
Llega un correo. Antes de que un asistente escriba la primera línea de una respuesta, hay media docena de preguntas que resolver. ¿Factura, consulta o publicidad? ¿Hay en el texto una instrucción dirigida al asistente en lugar de al destinatario? ¿Qué flujo se encarga, y hace falta siquiera una respuesta? Hasta ahora, todo eso lo respondía el mismo gran modelo de lenguaje que después redacta la respuesta, y responde como sabe responder: con texto. A «¿Es urgente?» llega un párrafo del que un programa tiene que volver a extraer el sí, y lo seguro que estaba el modelo queda en secreto.
Desde este octubre la cosa cambia, y nos parece la noticia más emocionante del mundo de los modelos en mucho tiempo. Microsoft-Decision-1, Jev de TypeSafe y H2O-Lightning-4B de H2O.ai son modelos que no hacen otra cosa que decidir. Reciben un contenido y preguntas con respuestas predefinidas, y devuelven una probabilidad para cada respuesta, en una sola pasada.[1, 2, 3, 4] Microsoft lo llama una nueva capa de la pila de IA y escribe que el sector está dejando atrás la idea de que toda petición a un modelo tenga que acabar en contenido generado.[1] Nosotros lo leemos así: tras años en los que un modelo generalista recibía cualquier tarea, aparecen a su lado los primeros especialistas. Para una plataforma que construye agentes a partir de pasos individuales es un regalo, y además uno que se puede calcular. Hemos medido los tres en las decisiones de nuestros propios agentes; las cifras están más abajo. Antes merece la pena mirar de cerca qué devuelve exactamente un modelo así.
Un sí que se puede medir
Una petición a un modelo de decisión tiene dos partes. El estado (state) es el contenido del que se trata, por ejemplo un aviso de incidencia, un correo o un borrador de respuesta. Las preguntas (questions) dicen qué debe decidir el modelo sobre ese contenido, y cada pregunta tiene una de tres formas.[4, 5, 6] Una pregunta de sí o no, que los tres fabricantes llaman «noul», devuelve un único número entre 0 y 1, la probabilidad del sí. Una elección (choice) nombra la opción más adecuada de una lista que defines tú, junto con una probabilidad para cada opción. Una valoración (score) sitúa el contenido en una escala cuyos niveles describes tú y devuelve, además de la probabilidad por nivel, un valor ponderado que puede quedar entre dos niveles.
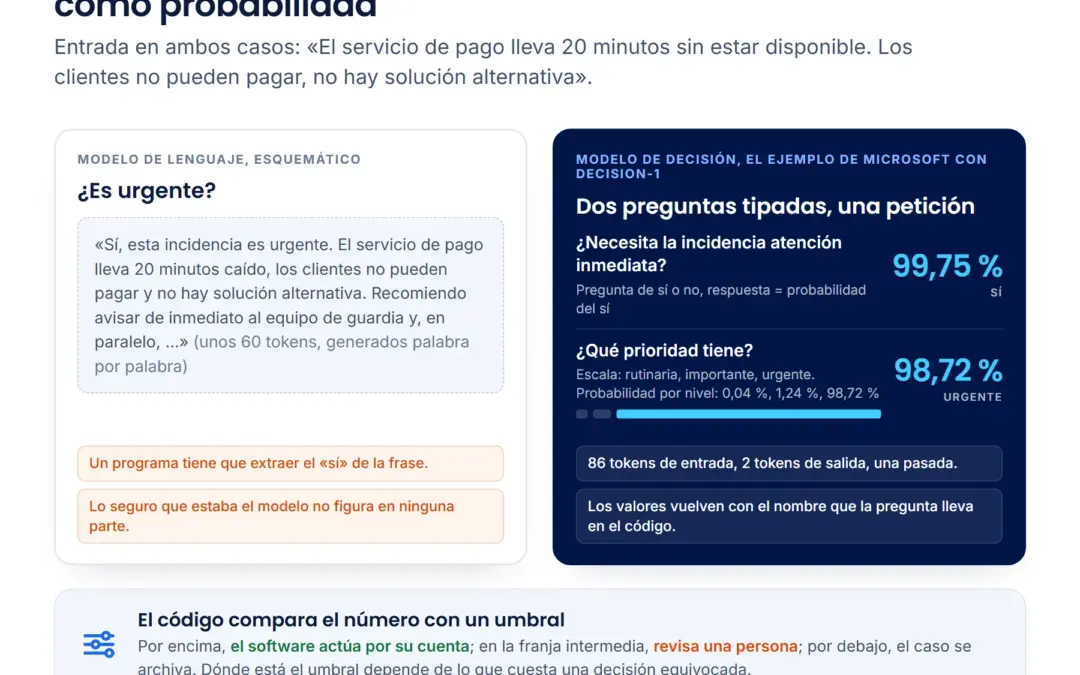
Microsoft lo muestra con un aviso de incidencia: «El servicio de pago lleva 20 minutos sin estar disponible, los clientes no pueden pagar, no hay solución alternativa». Con él van dos preguntas: si la incidencia necesita atención inmediata y qué prioridad tiene en una escala de rutinaria a urgente. El modelo respondió con un 99,75 por ciento para el sí y puso un 98,72 por ciento en el nivel «urgente». La petición completa costó 86 tokens de entrada y 2 tokens de salida.[7] Dos tokens porque se hicieron dos preguntas; el modelo nunca devuelve más. H2O describe la misma mecánica para su modelo en una frase: una pasada hacia delante, un token de salida por decisión.[4]
A esto se suman tres reglas que Microsoft y TypeSafe describen igual. Varias preguntas sobre el mismo contenido van en una sola petición, y el modelo las responde juntas. El nombre que le pones a una pregunta vuelve sin cambios en la respuesta, de modo que tu programa lee los valores directamente, sin interpretar una frase. Y cada pregunta pregunta exactamente una cosa: «¿Es urgente y relevante para el cliente?» se convierte en dos preguntas cuyas respuestas combina el código.[5, 6, 7]
Lo que promete la cifra
Una probabilidad vale tanto como su calibración. Microsoft y TypeSafe afirman haber entrenado sus modelos justo para eso; Microsoft formula el objetivo así: una predicción del 90 por ciento debería acertar unas nueve de cada diez veces en casos representativos.[2] TypeSafe añade el matiz: la calibración se mide sobre grupos de predicciones y, para una respuesta concreta, solo dice con qué frecuencia aciertan de media las respuestas de ese tipo.[3] Un valor de 0,98 puede fallar en el caso individual. Lo que te revela es la tasa de acierto de su clase, y eso es más de lo que una frase de texto ha revelado nunca.
Por eso el software trabaja con estos modelos mediante umbrales. Por encima de un umbral actúa por su cuenta, en una franja intermedia pregunta o recaba más información, por debajo el caso pasa a una persona o a un modelo más potente. Dónde están los umbrales depende del daño de una decisión equivocada; una acción difícil de deshacer necesita un umbral más alto que un acceso de lectura.[7, 8] Y antes de que un umbral automatice algo, conviene comprobar la calibración con los datos propios. Microsoft lo aconseja de forma expresa y recomienda, para preguntas en las que el modelo deba poder abstenerse, una opción propia del tipo «no lo puedo decir».[1, 6]
Tres modelos, un formato
Decision-1 llegó el 9 de octubre de 2026 al catálogo de modelos Foundry de Microsoft, reentrenado a partir de Qwen3.5-9B; Microsoft quiere basar las próximas versiones en modelos de OpenAI y en sus propios modelos MAI.[1] Jev está en acceso anticipado desde septiembre de 2026 en TypeSafe, una startup de San Francisco que entrena su modelo con un procedimiento propio llamado RLCD y ha bautizado la clase como «System One».[9, 10] H2O-Lightning-4B apareció en octubre con pesos abiertos bajo Apache 2.0 en Hugging Face; quien tenga una GPU lo descarga y lo ejecuta por su cuenta.[4] Tres fabricantes, tres modelos de negocio, y aun así la petición tiene el mismo aspecto en todas partes, en Microsoft y TypeSafe hasta en el nombre del punto de acceso systemone.[5, 6] Que tres proveedores lleguen por separado al mismo formato nos dice más sobre la madurez de esta clase que cualquier cifra aislada de un benchmark.
| Microsoft-Decision-1 | Jev | H2O-Lightning-4B | |
|---|---|---|---|
| Fabricante | Microsoft[1] | TypeSafe AI, San Francisco[10] | H2O.ai[4] |
| Disponible desde | Octubre de 2026 en Microsoft Foundry y a través de OpenRouter[1, 2] | Septiembre de 2026 en acceso anticipado a través de TypeSafe y OpenRouter; versión actual Jev 1.14 del 14 de octubre de 2026[9, 11] | Octubre de 2026, pesos abiertos en Hugging Face[4, 12] |
| Base | Qwen3.5-9B reentrenado[1] | Modelo propietario, entrenado con RLCD (Reinforcement Learning for Calibrated Decisions)[9, 10] | Qwen3.5-4B reentrenado, licencia Apache 2.0[4] |
| Tipos de pregunta | Sí o no, elección, valoración[6] | Sí o no, elección, valoración[5] | Sí o no, elección, valoración[4] |
| Entrada | Texto o JSON[6] | Texto; 64.000 tokens por petición, 32.000 por pregunta, modo de contexto largo hasta 262.000; inglés como idioma principal de entrenamiento[11] | Texto e imágenes; evaluado sobre todo en inglés[4] |
| Precio y operación | 0,042 dólares por millón de tokens de entrada, salida gratuita; zonas de cómputo en EE. UU. y la UE[1] | 0,042 dólares por millón de tokens de entrada, salida gratuita; servicio de TypeSafe[11] | Hardware propio, 9,3 gigabytes de pesos, medido por H2O en una sola GPU[4] |
Sobre el rendimiento, los tres fabricantes presentan mediciones propias. Microsoft comparó Decision-1 en 36 benchmarks con casi 150.000 preguntas excluidas del entrenamiento y declara la mayor precisión del campo con una latencia mediana unas 35 veces inferior a la de GPT-6 Sol; si se reformula la misma petición, el modelo cambia su decisión en el 1,3 por ciento de los casos.[2] TypeSafe anuncia «193,6 veces más rápido, 444,6 veces más barato» y muestra una decisión en 0,114 segundos por 0,000081 dólares frente a 8,566 segundos y 0,01388 dólares con un modelo de lenguaje, medido en flujos que TypeSafe denomina tareas System One.[10] H2O.ai comunicó el 12 de octubre de 2026 el primer puesto de la clasificación JevBench entre 104 sistemas con pesos abiertos, con 72,5 puntos por delante de Jev con 71,5, con una mediana de 29 milisegundos por decisión.[12] El orden de magnitud es el mismo en los tres: decisiones en milisegundos en lugar de segundos, a precios en los que la llamada individual deja de importar. Si eso vale también para nuestras tareas, queríamos saberlo por nosotros mismos.
Lo que medimos nosotros
Pusimos a los tres modelos a competir en las decisiones que nuestros agentes toman de todos modos: casos de nuestros conjuntos de prueba con respuesta correcta conocida, las mismas preguntas y las mismas opciones para cada modelo. Decision-1 y Jev respondieron desde sus servicios, H2O-Lightning-4B desde una sola tarjeta gráfica en un ordenador de nuestra propia oficina. Como referencia corrió en paralelo el modelo de lenguaje que hasta ahora respondía esos pasos. Fue la primera pasada de esta medición, sin reentrenamiento y sin ajustar los modelos a nuestros casos. Las muestras son pequeñas, cada cifra por separado es un indicio. La dirección es la misma en todas las filas.
En las 198 decisiones de 22 pasos de decisión en 17 de nuestros agentes, Decision-1 acertó 194 veces, Jev también 194 y H2O-Lightning-4B, un modelo pequeño de cuatro mil millones de parámetros, 192. El modelo de lenguaje llegó a 197, necesitó para ello una mediana de 660 milisegundos en lugar de 195 y costó por decisión entre seis y siete veces más que Decision-1. Al elegir el flujo responsable, Decision-1 y Jev acertaron en doce de doce casos, H2O-Lightning en once. Otras dos tareas las comparamos por su capacidad de separación, es decir, por lo bien que un modelo separa los casos que encajan de los que no, con independencia de cualquier umbral. La cifra para eso se llama AUC; 1,0 sería perfecto, 0,5 sería adivinar.
| Tarea de nuestros agentes | Microsoft-Decision-1 | Jev 1.14 | H2O-Lightning-4B |
|---|---|---|---|
| Zona de datos en MadeForPrivacy | Conforme al RGPD, zona de cómputo de la UE a través de Azure | Sin protección, servicio de TypeSafe en EE. UU. | Solo local, hardware propio |
| Decisiones con respuesta conocida, 198 casos | 194 aciertos (98,0 por ciento) | 194 aciertos (98,0 por ciento) | 192 aciertos (97,0 por ciento) |
| Elegir el flujo responsable, 12 casos | 12 aciertos | 12 aciertos | 11 aciertos |
| ¿Encaja un pasaje encontrado con la pregunta? 162 casos, capacidad de separación | 0,92 | 0,93 | 0,91 |
| ¿Hay una instrucción oculta en el texto? 345 casos, capacidad de separación | 0,97 | 0,98 | 0,97 |
| Valoración en una escala, 7 casos con rango esperado | 7 dentro del rango | 4 dentro del rango | 6 dentro del rango |
| Tiempo de respuesta, mediana | 195 milisegundos | 195 milisegundos | 38 milisegundos |
| Coste por decisión, media | unos 0,001 centavos de dólar | unos 0,002 centavos de dólar | ninguno por llamada; unos 3 a 4 vatios hora de electricidad por cada mil decisiones |
Tres cosas llaman la atención. Jev está entrenado sobre todo en inglés, H2O-Lightning evaluado sobre todo en inglés, y aun así los dos acertaron nuestros casos en alemán casi tantas veces como Decision-1. Los errores de los tres caen casi todos en sitios distintos; de las catorce decisiones equivocadas en total, solo hubo dos casos en los que fallaron dos modelos a la vez.
Segundo, las probabilidades. Cada modelo tiene su propia letra. En la pregunta sobre instrucciones ocultas, Jev reparte valores sistemáticamente más bajos que Decision-1 y separa los casos un poco mejor; H2O-Lightning pone algo menos de peso en la opción que elige que los otros dos, pero acierta el orden de sus opciones con la misma frecuencia. Por eso el umbral a partir del cual un flujo actúa por su cuenta se fija por modelo; la cifra que en uno significa «seguro» todavía no lo significa en otro. Con un umbral propio para cada uno, los tres quedaron a la par en la comprobación de instrucciones ocultas, hasta donde 345 casos permiten distinguirlos. En las valoraciones sobre una escala, Decision-1 mantuvo el rango esperado en los siete casos, H2O-Lightning en seis, Jev en cuatro, porque lleva sus valores hacia el centro de la escala; con descripciones de nivel ajustadas a cada modelo eso probablemente cambiaría, pero todavía no lo hemos medido.
Tercero, velocidad y precio. Decision-1 y Jev respondieron en una mediana de 195 milisegundos, por la red desde sus centros de datos. H2O-Lightning necesitó 38 milisegundos, en una sola tarjeta gráfica (una RTX 5090) en un ordenador de nuestra oficina, sin red de por medio. Al mismo precio por token, Jev cuesta aproximadamente el doble que Decision-1, porque divide el mismo texto en más o menos el doble de tokens; toda la serie de Jev, unas 3.900 llamadas, costó unos nueve centavos de dólar. H2O-Lightning no tiene precio por llamada; mil decisiones consumieron en nuestra tarjeta entre tres y cuatro vatios hora de electricidad. Y ninguno de los tres modelos dejó una sola petición sin responder en toda la serie.
Los tres corrieron donde están en casa: Decision-1 en la zona de cómputo europea de Microsoft a través de Azure, Jev en el servicio de TypeSafe en Estados Unidos, H2O-Lightning en nuestro propio hardware. En las zonas de datos de MadeForPrivacy eso se llama «Conforme al RGPD», «Sin protección» y «Solo local», y el resultado hace agradable esa asignación. Tres modelos que deciden más o menos igual de bien, uno por zona; quien quiera mantener sus datos en casa tiene en H2O-Lightning un modelo que en nuestra medición aguanta el ritmo. De los tres, solo H2O-Lightning se puede ejecutar en hardware propio; TypeSafe no ha publicado pesos, digan lo que digan por internet.[9]
En MadeForPrivacy los tres corren a través del mismo tipo de servicio, «Decisión». Qué modelo usa un paso lo fijas tú por zona de datos, sin cambiar el flujo; la lista de servicios por zona está en la página de integración.
Con Decision-1, el modelo de nuestra zona «Conforme al RGPD», dimos después un paso más allá de la comparación. Como primera etapa antes de la comprobación de instrucciones ocultas, de la que hablamos más abajo, lo medimos en 289 casos nuevos, 134 ataques y 155 contenidos inofensivos. La combinación detectó 129 ataques sin ninguna falsa alarma; la comprobación solo con el modelo de lenguaje llegó a 128 ataques con cuatro falsas alarmas. Solo el 13 por ciento de los contenidos necesitó aún el modelo de lenguaje, y el tiempo medio de comprobación bajó de 1,26 a 0,42 segundos. Dos observaciones nos llevamos de ahí. El enunciado de una pregunta cuenta: la misma decisión planteada en tres versiones se diferenció, en un conjunto pequeño, hasta en tres de ocho casos, sin que ninguna versión pareciera peor. Microsoft lo dice ella misma y aconseja probar el orden y la formulación de las opciones.[6] Y el modelo de lenguaje conserva su sitio allí donde acierta más: de 15 pasos que cambiamos a Decision-1 en nuestros flujos, 13 se quedaron; en dos el modelo de lenguaje decidía con más fiabilidad y sigue decidiendo allí.
Una ejecución de agente, descompuesta en decisiones
Volvamos al correo del principio. Microsoft habla de miles de pequeñas decisiones en torno a un número comparativamente pequeño de tareas generativas complejas,[1] y un asistente de bandeja de entrada muestra qué significa eso. Antes de escribir: ¿factura, consulta o publicidad? ¿Instrucción oculta? ¿Flujo responsable? ¿Hace falta respuesta? Después de escribir: ¿cumple el borrador los requisitos? ¿Falta algo? ¿Está la tarea terminada, o hace falta una aclaración? ¿Puede salir sin autorización? Un único paso de esta cadena genera texto. Todos los demás eligen de una lista corta.
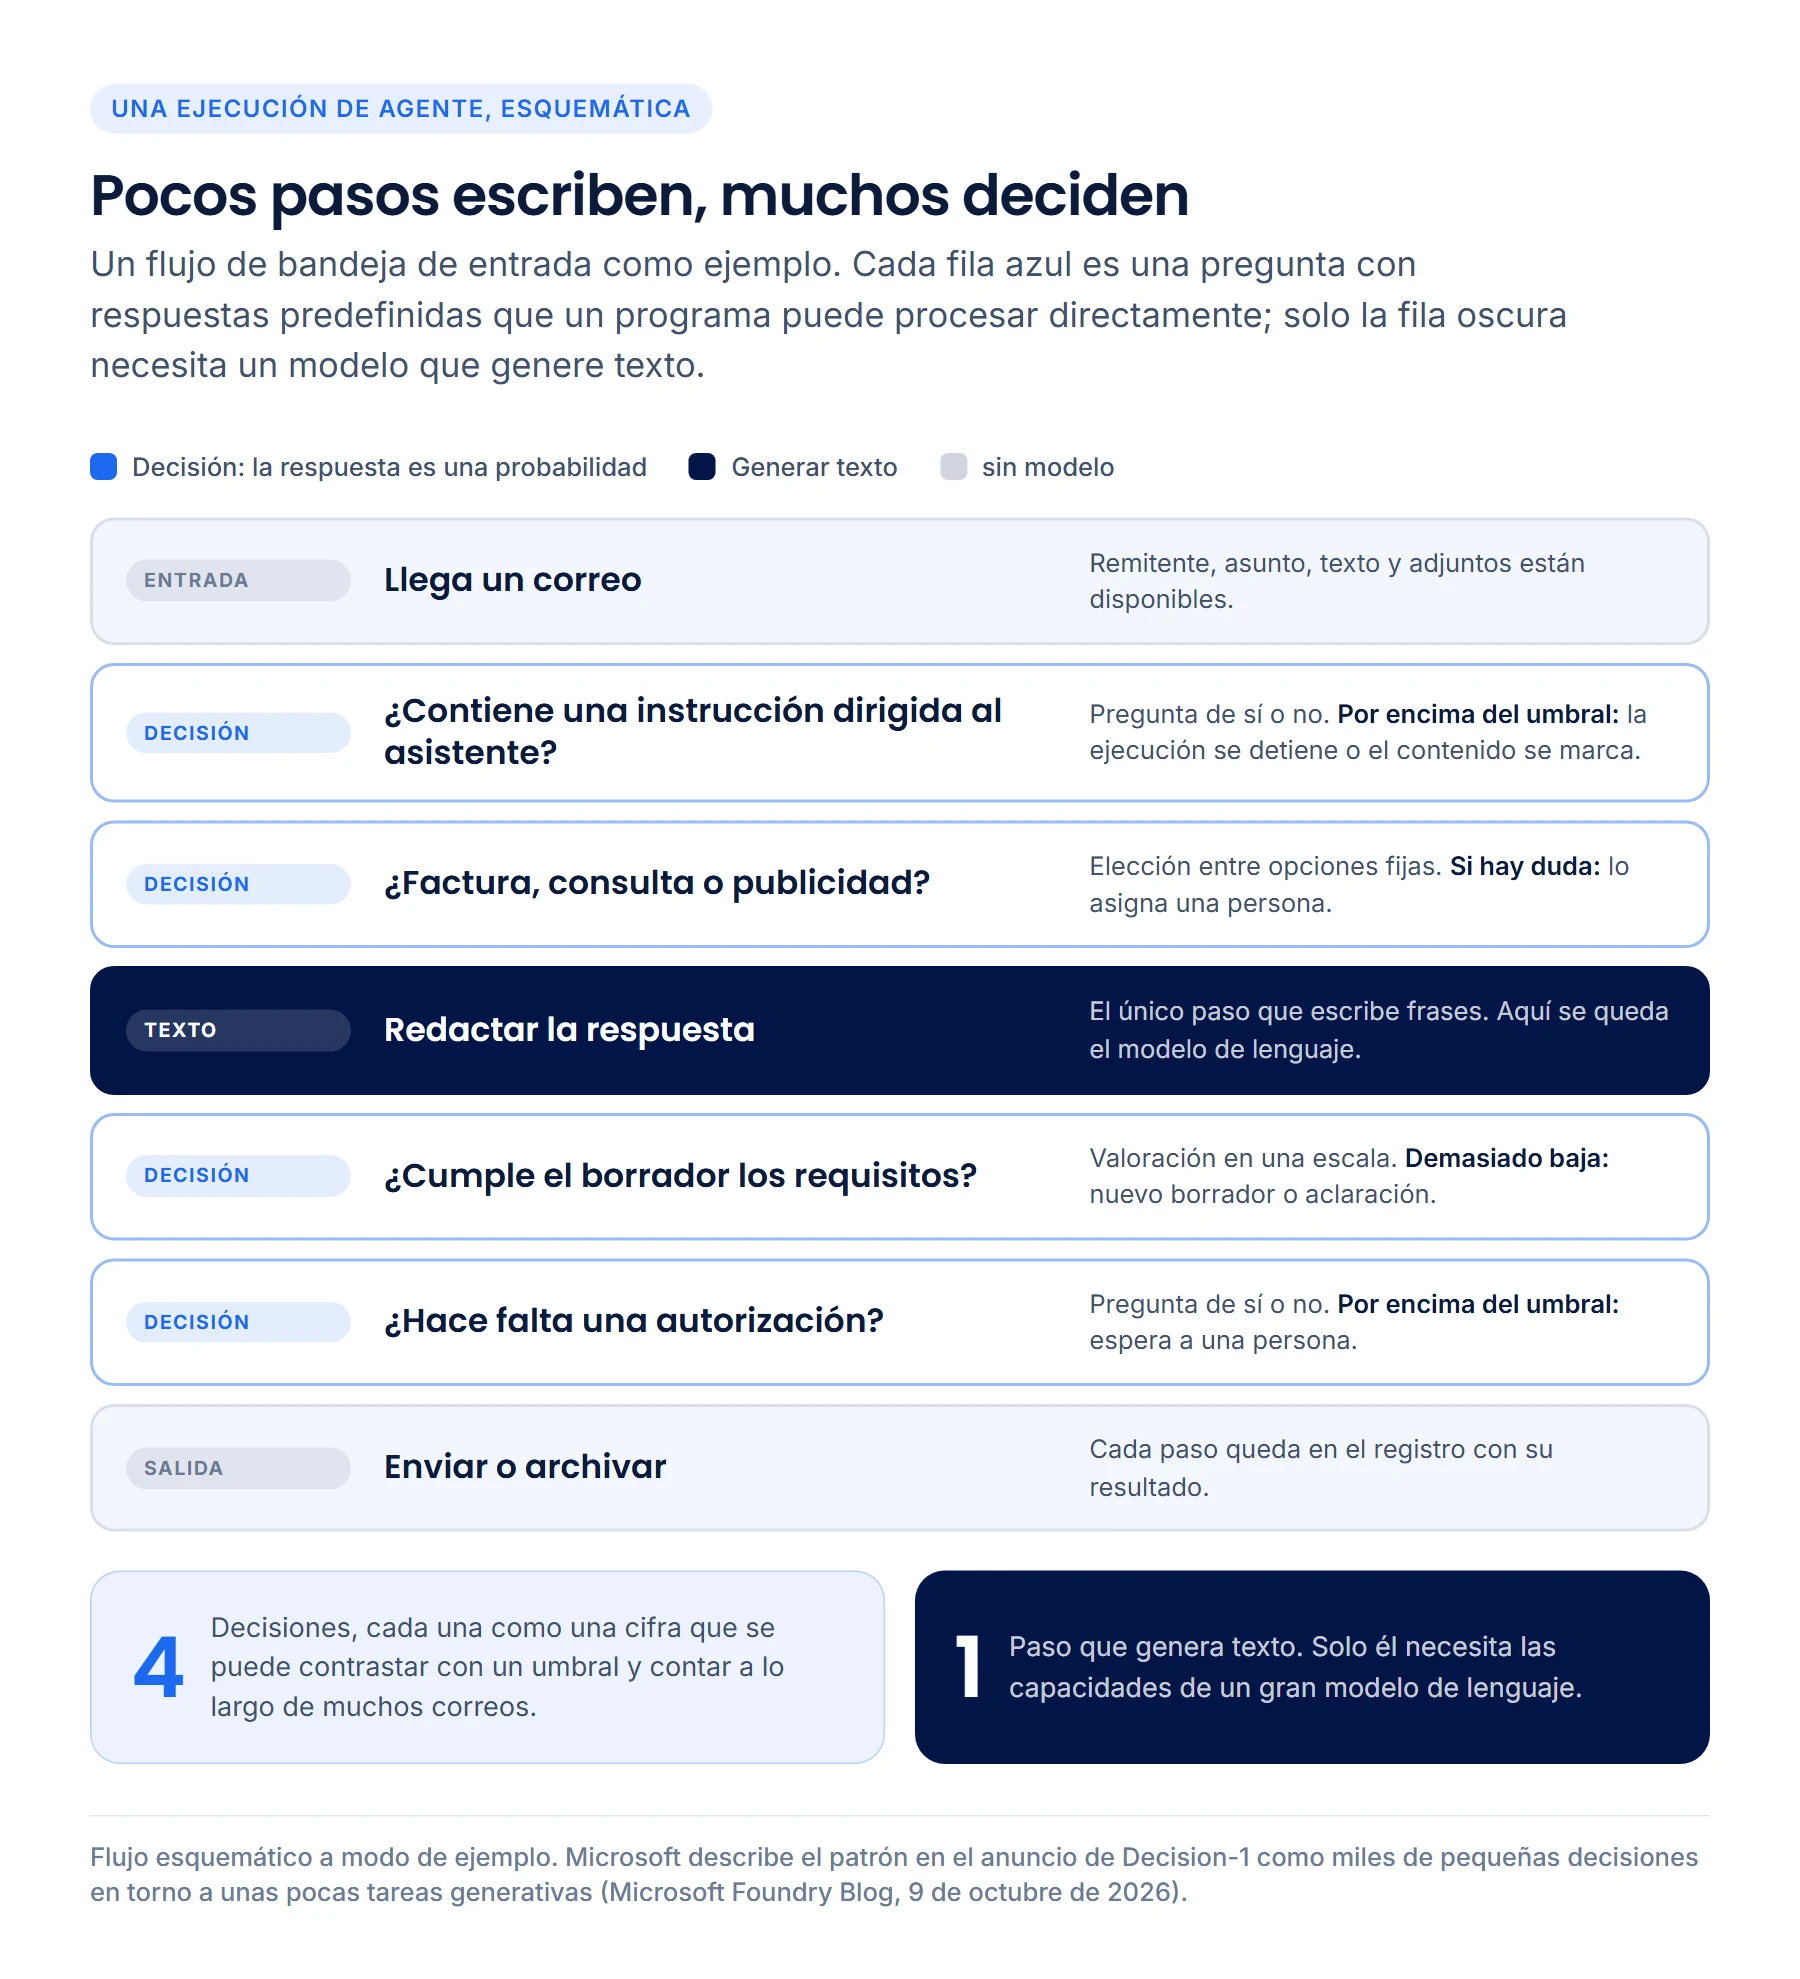
Respondida como probabilidad, cada una de estas preguntas cambia de carácter. Primero en el precio. A 0,042 dólares por millón de tokens de entrada, decidir sobre un correo de mil tokens cuesta menos de una centésima de céntimo; cinco decisiones por correo y diez mil correos al mes suman unos dos dólares.[1, 11] Comprobar sale más barato que omitir. Después en la medibilidad. Una probabilidad se puede contrastar con casos cuya respuesta correcta se conoce, y de ahí sale, para cada umbral, cuántos casos quedan bien, cuántos mal y cuántos sin decidir; así es exactamente como nacieron las cifras del apartado anterior. Después en el control. El umbral es un ajuste en lugar de una formulación dentro de una instrucción: quien quiera un flujo más estricto lo sube, quien quiera dejar pasar más casos automáticamente lo baja y ve en las cifras lo que eso cuesta. Y por último en la propia salida. Un modelo que solo elige entre respuestas predefinidas transporta en su respuesta únicamente números. La decisión se puede seguir influyendo; un texto colado, en cambio, ya no puede llegar por este camino al paso siguiente.
Qué significa esto para MadeForPrivacy
MadeForPrivacy construye los agentes como pipelines de pasos individuales. Qué paso se ejecuta cuándo lo fija la configuración; el pipeline dirige el flujo. Cada paso recibe el fragmento que necesita y usa el servicio de IA que tiene asignado. Qué servicios entran en consideración lo determina la zona de datos del agente, hasta llegar a «Solo local». Un modelo de decisión encaja en este cuadro como si estuviera hecho para él: es un servicio de IA como cualquier otro, con una zona, con cada llamada en el registro, y un paso que necesita un veredicto lo usa mientras los pasos que escriben se quedan con el modelo de lenguaje. Justo por eso pudimos hacer las mediciones de arriba con los casos de nuestros propios agentes: el paso de decisión recibe otro servicio, el resto del pipeline se queda como está.
Lo cerca que ya trabaja la plataforma de esto lo muestra el injection guard de nuestro artículo sobre prompt injection. Su segunda comprobación deja que un modelo de lenguaje decida si un texto contiene una instrucción colada; lo que cuenta es el veredicto, no el texto de alrededor, y un texto que no se pudo comprobar se considera «sin comprobar». Un modelo de lenguaje entrega un veredicto así solo dando un rodeo. Un modelo que de entrada solo devuelve una probabilidad se ahorra ese rodeo y, encima, devuelve una cifra que se puede contrastar con un umbral y contar a lo largo de muchos correos. La cascada de nuestras pruebas, Decision-1 delante y el modelo de lenguaje para el 13 por ciento incierto, es este principio en cifras.
En protección de datos, a un modelo de decisión se le aplica la misma regla que a cualquier servicio de IA: el contenido sobre el que se decide va al servicio, así que la zona de datos del agente fija qué servicio entra en consideración. Lo bonito de esta clase de modelos es que hoy hay un representante para cada una de las tres zonas. H2O-Lightning-4B corre con 9,3 gigabytes de pesos en una sola GPU en tu propia casa, y la licencia permite el uso comercial; como servicio en hardware propio pertenece a la zona «Solo local».[4] Microsoft ofrece Decision-1 en Foundry también en la zona de cómputo de la UE; así lo usamos nosotros, en la zona «Conforme al RGPD».[1, 6] Jev corre como servicio de TypeSafe en San Francisco y pertenece por ello a la zona «Sin protección».[10] Qué servicios de IA hay en cada zona lo recoge la página de integración. Cuál de ellos puede usar un agente lo decide su zona, y el registro muestra por paso qué servicio respondió. A eso se suma una ventaja que está en la naturaleza de estos modelos: lo que vuelve es un único número. Una reproducción del contenido ni siquiera llega a existir en el camino de vuelta.
Dónde están los límites
Un modelo de decisión entrega su veredicto sin justificación. Recibes 0,93, y quien necesite además un motivo, por ejemplo para la respuesta a un cliente, lo sigue obteniendo de un modelo de lenguaje.[3, 6] Calcular se lo deja al código: plazos, sumas y comparaciones los calcula tu programa antes, como recomienda TypeSafe, y el modelo recibe el resultado.[9] Jev está entrenado sobre todo en inglés, H2O-Lightning evaluado sobre todo en inglés; otros idiomas los procesan ambos según sus fabricantes, con pérdidas.[4, 11] Los tres trabajaron en alemán durante todas nuestras pruebas. Y la calidad de una decisión depende de las opciones que definas. Si la respuesta correcta falta en la lista, el modelo reparte su probabilidad igualmente sobre la lista; una opción «ninguna de estas» la tienes que prever tú.[6]
Antes de que un modelo así decida en un flujo, conviene por tanto medirlo, con casos de la propia operativa cuya respuesta se conoce, y mirando dónde tiene que estar el umbral para que los casos inciertos acaben en una persona o en un modelo más potente. Quien lo hace obtiene la cuenta de arriba: decisiones en milisegundos, por fracciones de un céntimo, cada una como una cifra que se puede contar a final de mes. Para nosotros es el comienzo de un reparto de tareas que deseábamos desde hace tiempo, con especialistas para el veredicto y el modelo de lenguaje para el texto. Cómo encajan pipelines, zonas de datos y el registro por paso lo muestra la página de la plataforma de agentes; la investigación detrás de la selección de modelos y los pasos de comprobación está en nuestros fundamentos científicos.
Preguntas frecuentes
¿Qué es un modelo de decisión?
Un modelo que entrega una decisión en lugar de texto. Recibe un contenido y preguntas con respuestas predefinidas (sí o no, elección de una lista, nivel en una escala) y devuelve una probabilidad para cada respuesta, en una sola pasada. Microsoft-Decision-1, Jev de TypeSafe y H2O-Lightning-4B son tres representantes; TypeSafe llama a la clase «System One».[1, 3, 4]
¿Existen modelos de decisión con pesos abiertos?
¿Cuánto cuesta una decisión con Decision-1, Jev o H2O-Lightning?
Decision-1 y Jev cobran 0,042 dólares por millón de tokens de entrada; los tokens de salida son gratuitos. El ejemplo de Microsoft con dos preguntas sobre un aviso de incidencia necesitó 86 tokens de entrada y costó así unos 0,0000036 dólares; en nuestras pruebas, Decision-1 salió de media a unos 0,001 centavos de dólar por decisión, Jev a unos 0,002, porque divide el mismo texto en más tokens. H2O-Lightning-4B corre en hardware propio sin precio por llamada; mil decisiones consumieron en una tarjeta gráfica entre tres y cuatro vatios hora de electricidad.[7, 11]
¿Qué tal fueron Decision-1, Jev y H2O-Lightning en las pruebas de MadeForPrivacy?
En 198 decisiones de 22 pasos de decisión de nuestros agentes, Decision-1 y Jev acertaron cada uno 194 veces, H2O-Lightning-4B 192, el modelo de lenguaje 197. Decision-1 y Jev respondieron en una mediana de 195 milisegundos, H2O-Lightning en una tarjeta gráfica de nuestra oficina en 38, el modelo de lenguaje en 660. Fue la primera pasada sin reentrenamiento y las muestras son pequeñas; quien use uno de los modelos lo vuelve a medir en sus propios casos.
¿Puede equivocarse un modelo de decisión?
¿Sustituyen los modelos de decisión a los modelos de lenguaje?
Fuentes
- Introducing Microsoft-Decision-1 in Microsoft Foundry for decision and classification workloads.
- Introducing Microsoft-Decision-1, our model for fast decision-making.
- System One models.
- H2O-Lightning-4B.
- API reference: POST /v1/systemone.
- Deploy and use Microsoft-Decision-1 in Microsoft Foundry.
- Not Every Decision Needs an LLM: Getting Started with Microsoft-Decision-1.
- Confidence.
- What Is Jev? TypeSafe's Decision Model Explained for Developers. · OpenRouter distribuye Jev; citado por la fecha de lanzamiento, el modelo propietario y la recomendación de hacer los cálculos en el código
- TypeSafe AI: System One Models. · datos de rendimiento del fabricante, nota al pie «based on workflows for System One tasks»
- Models.
- H2O-Lightning-4B Ranks First on JevBench Open-Weights Leaderboard. · difusión por Business Wire; los valores de benchmark son datos del fabricante
Todas las fuentes consultadas por última vez el 25 de octubre de 2026. Los datos de rendimiento y precio de Decision-1, Jev y H2O-Lightning proceden de los fabricantes. Los valores del apartado «Lo que medimos nosotros» proceden de la primera pasada de nuestra propia medición con los conjuntos de casos de nuestros agentes frente a Microsoft-Decision-1, Jev y H2O-Lightning-4B, sin reentrenamiento; el tamaño de la muestra y el modelo de comparación se indican en cada caso. Los datos de hardware y consumo de H2O-Lightning-4B son mediciones propias en un ordenador de trabajo. Las afirmaciones sobre MadeForPrivacy describen el estado del software en octubre de 2026.
Demo en vivo
Deja que decida lo que se puede medir.
En la demo en vivo te mostramos cómo se construye un agente a partir de pasos individuales, qué paso usa qué servicio de IA y qué queda de todo ello en el registro.